如何高效使用YashanDB PL语言?这5点建议值得收藏

如何高效使用YashanDB PL语言?这5点建议值得收藏
用户10349277
发布于 2025-02-18 14:53:17
发布于 2025-02-18 14:53:17
01 背景
PL语言(Procedural Language) 是一种程序语言, 又称过程化结构查询语言,它是一种建立在普通SQL语言之上的编程语言。
讨论PL语言是一个有意思的话题,因为软件行业被大数据、组件化的思想浪潮捶打过多年,所以多数从业人员一旦提及PL语言,都会在心里冒出一句疑问,“那不是已经过时的语言?”
那为什么YashanDB还要选择开发PL语言?正所谓仁者乐山,智者乐水,笔者的观点是:在技术领域,没有绝对的对错之分,关键在于是否合适。物竞天择,在软件行业,最合适应用业务实现的技术会用行动来投票决定。
如电信、证券、银行等传统行业,强调业务的高并发和高可用,通过PL语言来实现业务应用逻辑是主流选择。而在互联网行业,选择PL语言来实现业务逻辑的几乎绝迹,替代的是,业务广泛通过各种CRUD技术中间件 + JDBC,将业务的逻辑实现转移到数据库之外。
PL语言之所以成为很多业务的选择,在于其独特的特性价值:
- PL语言具备高级语言的可编程属性,支持面向过程、面向对象的编程实现,具备业务逻辑直接在数据库中实现的条件;
- 区别于不同组件间交互方案,大大减少了网络传输开销,明显降低业务功能端到端实现复杂度,提升业务稳定性和可靠性;
- 高度集成SQL,在数据库批量SQL操作下具有明显的性能优势;
- Oracle兼容性重要组成,在传统行业大量存量业务的迁移时,PL语言的兼容性成为降低成本的关键因素。
因此笔者认为除非发生巨大的技术变更,PL语言特性将在相当长的一段时间内会持续保持很强的竞争力。
在之前一篇论述Oracle兼容性的文章中,笔者以整个数据库视角来论述过国产数据库在这个方面应该达到的4个标准。(可点击此处查看文章:《论Oracle兼容性,我们需要做什么?》)当这个范围缩小到PL语言时,Oracle兼容性的视角该如何呈现呢?
640 (1).png
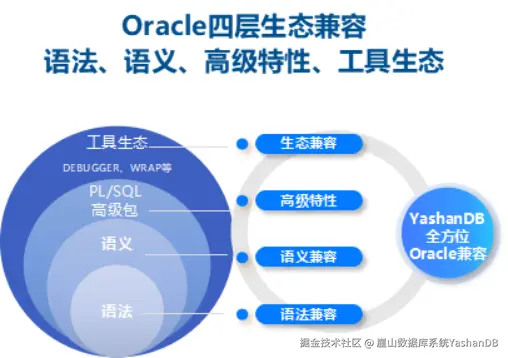
Oracle兼容性是目前国产数据库最主要的一个工作任务,这个任务直接决定了数据库在做商业迁移时的成本,是商业竞争力的一个重要指标。类比于SQL语言,在PL语言视角上也做了四层划分。
- 第一层要求是做到PL语言的语法完全兼容,即Oracle实现的PL语言元素,如变量定义、函数定义、循环、控制、SQL调用、函数调用、异常语句等,从语法格式上完全对应;
- 第二层要求是做到PL语言的语义完全一致,即各类语法承载的语义要求,还有块、数据区、语句区、子过程、异常处理等,从语义实现上完全对应;
- 第三层要求是做到PL语言的高级特性相同,包括承载PL语言的对象,包括匿名块、过程、函数、触发器、高级包等在数据字典管理、触发机制、工作原理上全面兼容;同时提供好主流的Oracle系统自带的高级包功能,避免存量业务代码的修改;
- 第四层要求是做到PL语言的生态支持,如PL语言要具备易用的调试工具、承载安全特性的PL语言加密工具等,实现生态上的完整。
Oracle兼容性不是一个简单的模仿行为,而是一个非常复杂和工程量庞大的逆向工程。目前国产数据库应该秉持务实的态度,专注于核心功能的实现和完善,同时确保高度的兼容和已实现功能的稳定性。
YashanDB作为一款全自研的数据库,从Oracle兼容性角度上技术具备一定优势。经过几年不断的打磨,在PL语言特性上已初露头角。目前已推出的YashanDB数据库版本PL特性具备以下优点:
- 高度SQL集成;
- 完整的可编程逻辑;
- 高性能;
- 便捷的可调试性。
以下将围绕上述优点,展开描述YashanDB PL语言实现范围。
02 YashanDB PL语言优点
高度SQL集成
640(2).png
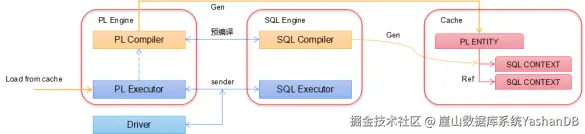
上图为YashanDB PL语言特性实现架构。图示可见,PL引擎与SQL引擎在层次上是完全解耦的,通过SQL引擎绑定参数特性完成SQL语句的编译和执行,SQL产生结果集通过sender接口输出。通过缓存机制,完成PL和SQL编译体的缓存,便于使用时可以快速执行。在此架构下,PL语言是可以完全发挥SQL引擎支持的所有能力。
PL语言与结构化查询语言SQL的结合非常紧密,具体表现在以下方面:
- 允许静态SQL操作,即直接使用所有的DQL、DML数据操作,事务控制语句,语句中完全支持内置函数、高级包的子函数、运算符和伪列;
- 允许通过动态SQL方式进行所有SQL操作。该特性主要是由静态SQL支持范围进一步放开了DDL语句特性;
- 完全支持SQL中定义的所有数据类型,包括数值、字符串、RAW、BOOLEAN、大对象等数据类型;
- 支持游标变量,提供了灵活的游标OPEN、FETCH、CLOSE、赋值、入参、出参、提前返回结果集等操作SQL的能力;
- 支持%TYPE,%ROWTYPE等类型继承能力,而无需显式指定该数据类型;
- 运行DQL查询时普通游标将会一次处理查询结果集的一行,BULK游标可以支持一次处理一批;
- SQL操作产生异常时,均可以通过异常模块的编程进行捕获。
完整的可编程逻辑
640 (2).png
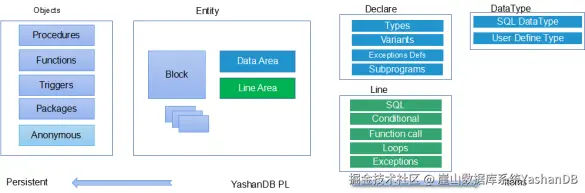
SQL语言是一种数据描述语言,PL语言则是极大的扩展了数据库的可编程逻辑。PL语言源于元老级的Ada语言,SQL/PSM为业界标准,Oracle的PL/SQL语法形式为当前事实标准。可以实现面向过程、面向对象两种编程形式。
- 基础要素为语句块BLOCK,可以分为数据区和语句区两部分。多个语句块顺序或叠加,在运行时形成一种栈式的调用;
- 数据区支持类型定义、变量定义、缺省表达式声明、异常变量定义、子过程定义等功能;
- 除了支持SQL所有的数据类型,可以支持自定义类型,可定义数组、OBJECT、NEST TABLE等向量形式,类型可支持对应的方法。通过UDT可支持面向对象方法编程;
- 语句区提供了循环、条件、跳转、SQL调用、函数调用、异常处理等可编程语言逻辑;
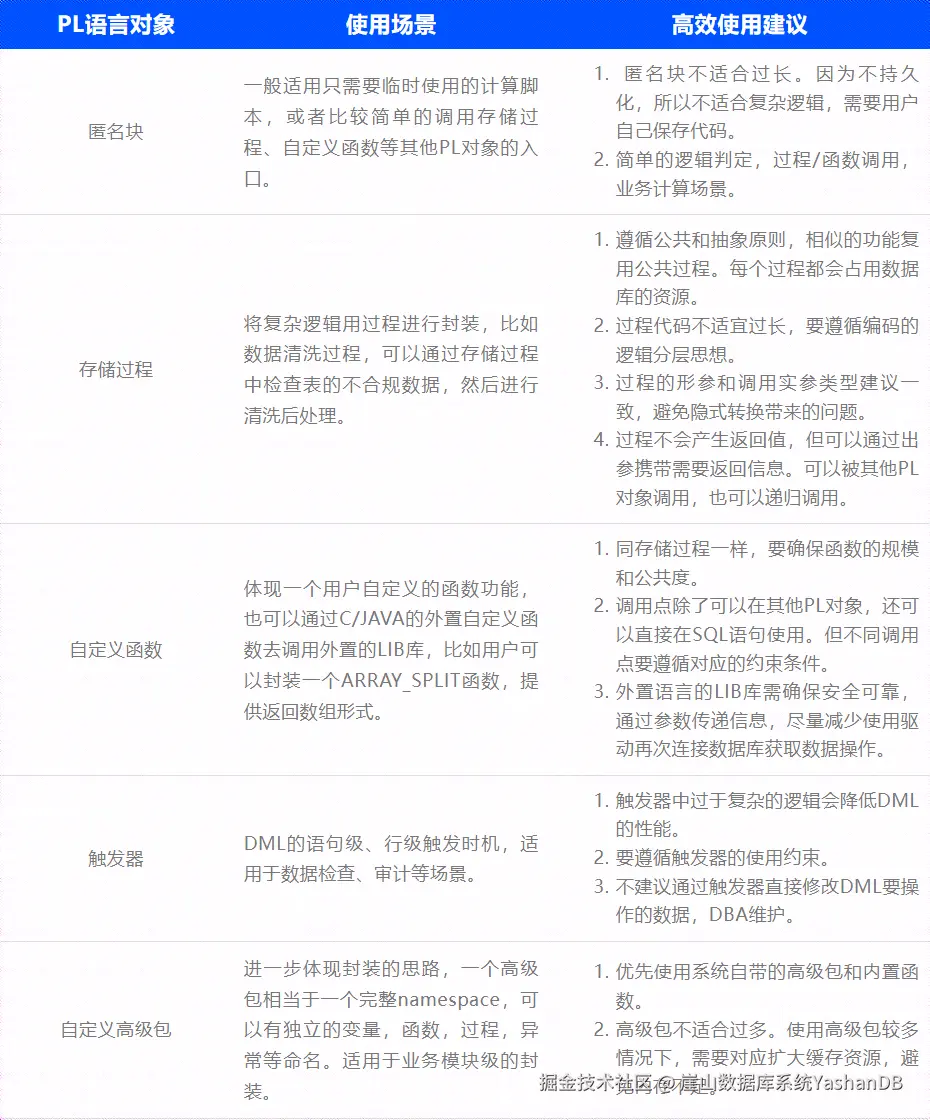
- 在对象持久化层面提供了存储过程、自定义函数、触发器、自定义高级包、匿名块等多种数据库对象形态,提供了不同的触发时机和持久化机制,适用于不同的使用场景;
- YashanDB PL语言完全遵循Oracle兼容性,以Oracle实现的PL特性移植修改代价小。
高性能
PL语言通过可编程逻辑和SQL集成,可以带来以下明显的好处:
- 高效地数据批处理;
- 显著降低客户端和数据库服务端的交互次数;
- 减少网络流量损耗;
- 数据库可实现的业务逻辑能力;
- 提高业务处理的可靠性。
便捷的可调试性
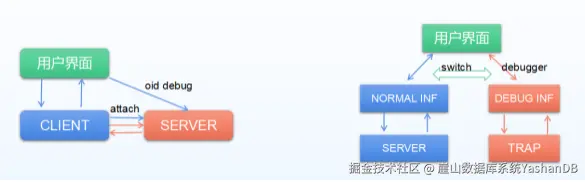
使用PL语言程序很大阻力在难以调试PL语言程序。YashanDB支持断点、STEP INTO、STEP OUT、变量查看、调用栈查看、源码查看等功能。极大方便用户进行PL语言的跟踪定位。
与业界常见的调试器实现方案不同,YashanDB实现了一个轻量级的DEBUGGER,不需要组织不同的调试语句,不存在查看会话看板,不需要去ATTACH操作;一键启动调试,使用复杂度大大降低。
YashanDB PL语言的调试器特性,近期即将发布。
640 (3).png
03 如何高效地使用YashanDB PL语言
笔者从基于PL语言开发者的角度,给出若干条建议如下:
- 根据业务应用选择合适的PL对象,确保PL对象的规模适中;
- 根据业务处理逻辑选择高效地语句;
- SQL查询相关的PL特性选择;
- 减少对象的级联调用,合适的使用递归或嵌套调用;
- 减少在线DDL操作,避免失效。
以下根据提供建议,进行逐个展开。
建议1:根据业务应用选择合适的PL对象,确保PL对象规模适中
如下表,笔者给出PL语言对象推荐使用场景和高效使用建议,提供大家参考。
微信图片_20240710142834.png
建议2:根据业务处理逻辑选择简洁高效地语句
这个章节,笔者将通过举1个游标特性相关例子给大家一个直观的感受:
sql 代码解读复制代码DECLARE
  cursor cur1 is select column1 c1 from table1;
  result cur1%rowtype;
BEGIN
   open cur1;
   loop
       fetch cur1 into result;
       exit when cur1%notfound;
       process(result);
   end loop;
   close cur1;
END;
/
其实通过例子的分析,这个特性是完成游标的遍历,所以实际上选择FOR语句,可以更为简洁的完成相应功能。改写后例子如下:
sql 代码解读复制代码BEGIN
   for result in (select column1 c1 from table1) then
       process(result);
   end for;
END;
/
是不是整体简洁度高了很多?实际在PL语言中提供了很多逻辑行语句,语句间并不存在好坏,需要从业务逻辑角度选择合适的语句去实现。
建议3:SQL查询相关的PL特性选择
PL语言中常见的使用SQL的方式,有静态SQL特性、游标、动态SQL等。常见的业务逻辑是通过SQL获取数据后,需要进一步加工处理,然后返回处理后结果。
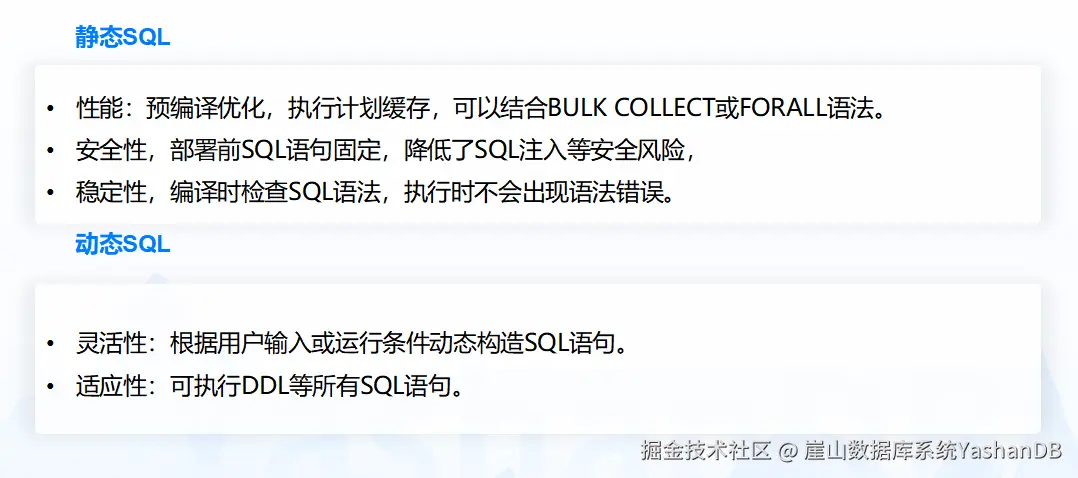
建议优先选择静态SQL特性,有以下原因:
- 相对于动态SQL,PL编译器是感知静态SQL语句,有错误将在编译期就指出;
- 静态SQL语句编译完成后,可以被PL编译体引用,执行阶段不需要触发编译,这样执行更为高效;
- 静态SQL语句可以使用隐式游标属性来获取SQL执行状态。
640 (4).png
其次推荐使用游标特性。游标是非常灵活的查询方式,而且存在多种游标形态,常用的为显式游标和系统游标。但相对于其他SQL查询特性,游标是需要变量形式承载,额外占用变量资源,同时遵循PL语言中变量的栈生命周期管理。
最后再是使用动态SQL特性。动态SQL适用于资源动态生成、动态拼接SQL语句和执行DDL语句,PL编译阶段难以检测的,需要到执行阶段进行编译执行,灵活度高但执行效率较低。
以上是三种常见的SQL查询相关PL特性比较,当然PL特性没有绝对的选择好坏,只有合适业务逻辑实现的才是最好的。
建议4:减少对象的级联调用,合适的使用递归或嵌套调用
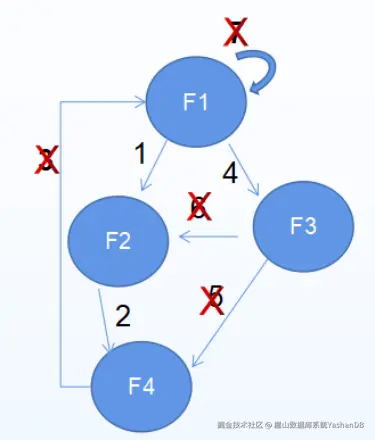
合理规划的函数调用,可以减少编译复杂度。如下举例,给了一个较为复杂的嵌套调用,从调用关系上形成了一个有向环图。
sql 代码解读复制代码CREATE FUNCTION F1 RETURN INT IS
  result INT := 1;
BEGIN
  result := F2();
  result := result + F3();
  result := result + F1();
  return result;
END;
/

CREATE FUNCTION F2 RETURN INT IS
  result INT;
BEGIN
  result := result + F4();
  return result;
END;
/

CREATE FUNCTION F3 RETURN INT IS
  result INT;
BEGIN
  result := result + F2();
  result := result + F4();
  return result;
END;
/

CREATE FUNCTION F4 RETURN INT IS
  result INT;
BEGIN
  result := result + F1();
  return result;
END;
/
一个有向环图按级联编译方式,通过深度遍历优先方式进行编译时,会优先按调用链寻找叶子节点,级联展开编译。
如果深度过深,会使得编译链过深,占用大量编译资源。如图所示,我们在进行级联编译时,针对递归、嵌套、相同编译流程多次重复调用的函数等各种情形,会进行检测并及时剪枝。
640 (5).png
当然笔者认为函数调用不可避免会出现递归和嵌套调用的情形出现,所以选择如何在合适的时机选用递归和嵌套调用,这是编程关键。但不可以滥用,必须有合适的退出条件,避免对资源产生极大损耗。
建议5:减少在线DDL操作,避免失效
如果有一个数据库对象的编译使用了另一个对象的元数据信息,两个对象间就存在了依赖关系。如果被依赖对象发生了元数据信息一旦发生变更(元数据变更发生,即产生了DDL操作),依赖对象编译信息就失效了。
因为PL对象常见的实现逻辑,是封装大量的SQL调用,PL对象调用等,所以一个PL对象会产生大量的依赖对象。当依赖对象发生DDL,比如一个表动态增删了列,那么依据这个表的查询绑定的游标,其继承属性可能就会发生变化。再举一个例子,比如实现了一个自定义公共的字符串替换函数,当这个函数的实现发生变更,那么所有依赖这个公共函数的PL对象、SQL语句等都应该发生失效重编译的动作,否则原编译结构中包含的实现逻辑就是错误的。
在PL对象实现时,会根据PL对象的依赖关系构造依赖链。如果一个对象发生元数据变更,那么这个依赖链上所有的对象都会被病毒似的传染失效。如果有大量的对象失效,那么在调用时可能会产生大量的重编译动作,极端情况会导致资源的突发损耗,甚至耗尽报错,性能也会产生极大的波动。
所以建议一个PL对象的依赖对象适当要控制规模,而且通过预先执行DDL方式,确保缓存中编译体有效。如果必须有DDL操作,那么建议在DDL操作完成后,通过ALTER RECOMPILE的命令,将PL对象提前编译为有效状态。
此外在YashanDB PL语言实现过程中,我们发现这种问题,也及时做出了一些应对措施,比如通过松耦合操作,及时剪断病毒式的传染。
尽管如此,PL语言仍存在部分不足:
- PL语言的编写质量看DBA能力,难以用质量手段衡量;
- PL语言直接运行在数据库上,难以做好资源隔离,可能会影响主业务;
- PL语言的安全、审计、运维等多个角度对DBA要求比较高;
- PL语言在不同数据库间差异很大,难以移植。
如何有计划、有节奏地实现Oracle的PL语言特性,并能进一步克服PL语言的缺点,这是国产数据库在PL语言特性上面对的主要问题。比如第一点,PL语言是缺乏其他高级语言的UT测试框架、静态检查工具、内存工具等各种开发者生态工具,此外覆盖率报告、内存泄露检查等完全缺失。
作者:崖山数据库系统YashanDB 链接:https://juejin.cn/post/7389912518704332812 来源:稀土掘金 著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
本文系转载,前往查看
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号