R语言|数据清洗


数据清洗是数据分析流程中必不可少的一步。清洗得当的数据是可靠分析的基础,而在R语言中,有许多强大而灵活的工具可以帮助我们高效完成数据清洗。本文将全面介绍R语言数据清洗的常见技巧,并配以具体的代码示例。
数据清洗常见的任务包括:处理缺失值、数据格式转换、去除重复数据、修正异常值、数据标准化、数据分组与聚合、文本数据清理。
TIPS
R语言数据清洗常用工具
1. Base R
R语言自带的base包提供了许多内置函数用于数据清洗,例如is.na()、duplicated()等。
2. dplyr
dplyr是R语言中最受欢迎的数据操作包之一,擅长数据清洗和操作,语法简洁直观。
3. tidyr
tidyr专注于整理数据,提供了诸如pivot_longer()、pivot_wider()等功能。
4. stringr
stringr专注于字符串处理,适合清理文本数据。
5. 其他工具
根据需求还可以使用lubridate处理日期时间数据,janitor快速清理变量名等。
TIPS
使用示例
缺失值处理:缺失值处理是数据清洗的第一步。可以选择删除、填充或插值的方法。
# 创建示例数据
library(dplyr)
data <- data.frame(
  ID = 1:5,
  Age = c(25, NA, 30, 35, NA),
  Salary = c(50000, 55000, 60000, NA, 70000)
)# 检测缺失值
is.na(data)
# 删除含有缺失值的行
data_clean <- data %>% na.omit()
# 使用均值填充缺失值
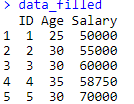
data_filled <- data %>%
  mutate(
    Age = ifelse(is.na(Age), mean(Age, na.rm = TRUE), Age),
    Salary = ifelse(is.na(Salary), mean(Salary, na.rm = TRUE), Salary)
  )
data_filled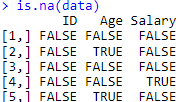
格式转换:在数据清洗中,经常需要将列转换为合适的数据类型。
# 转换字符型到因子型
data$ID <- as.factor(data$ID)
# 日期格式转换
library(lubridate)
data$Join_Date <- c("2022-01-01", "2023-05-12", NA, "2023-06-15", "2024-09-20")
data$Join_Date <- as.Date(data$Join_Date)去除重复值:有时候数据集中可能存在重复行,需要清理。
# 示例数据
data <- data.frame(
  ID = c(1, 2, 2, 3, 4),
  Age = c(25, 30, 30, 35, 40)
)
# 检测重复
duplicated(data)
# 删除重复行
data_unique <- data %>% distinct()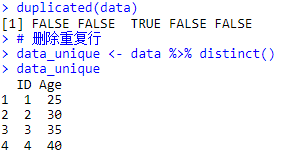
修正异常值:通过计算分位数或使用业务规则修正数据中的异常值。
# 示例数据
data <- data.frame(
  ID = 1:10,
  Salary = c(50000, 55000, 60000, 70000, 75000, 80000, 85000, 900000, 95000, 100000)
)
# 使用IQR方法检测异常值
Q1 <- quantile(data$Salary, 0.25)
Q3 <- quantile(data$Salary, 0.75)
IQR <- Q3 - Q1
# 修正异常值(截断法)
data$Salary <- ifelse(
  data$Salary > Q3 + 1.5 * IQR | data$Salary < Q1 - 1.5 * IQR,
  NA, data$Salary
)
data <- na.omit(data)数据标准化:将数据缩放到同一量纲,例如归一化或标准化。
# Min-Max归一化
data$Salary_normalized <- (data$Salary - min(data$Salary)) / (max(data$Salary) - min(data$Salary))
# Z-Score标准化
data$Salary_standardized <- scale(data$Salary)数据分组与聚合:对于分组和汇总操作,dplyr非常方便。
# 示例数据
data <- data.frame(
  Department = c("HR", "IT", "HR", "IT", "Finance"),
  Salary = c(50000, 70000, 55000, 80000, 75000)
)
# 按部门分组并计算平均薪资
data_summary <- data %>%
  group_by(Department) %>%
  summarize(
    Avg_Salary = mean(Salary, na.rm = TRUE),
    Count = n()
 )
data_summary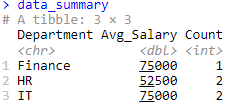
清理文本:数据利用stringr包处理字符串数据。
library(stringr)
# 示例数据
data <- data.frame(
  Name = c("  Alice ", "Bob", "Charlie   ", "D@vid", "Eve  ")
)
# 去除前后空格
data$Name <- str_trim(data$Name)
# 替换特殊字符
data$Name <- str_replace_all(data$Name, "[^a-zA-Z]", "")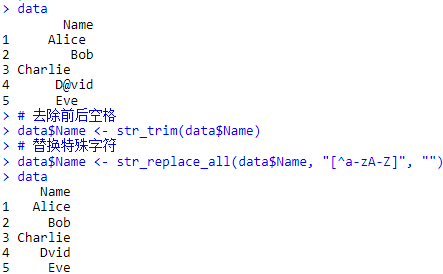
TIPS
综合示例
library(dplyr)
library(stringr)
library(lubridate)
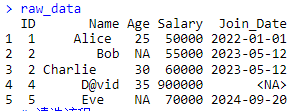
# 原始数据
raw_data <- data.frame(
  ID = c(1, 2, 2, 4, 5),
  Name = c("  Alice ", "Bob", "Charlie   ", "D@vid", "Eve  "),
  Age = c(25, NA, 30, 35, NA),
  Salary = c(50000, 55000, 60000, 900000, 70000),
  Join_Date = c("2022-01-01", "2023-05-12", "2023-05-12", NA, "2024-09-20")
)
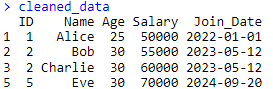
# 清洗流程
cleaned_data <- raw_data %>%
  distinct() %>%
  mutate(
    Age = ifelse(is.na(Age), mean(Age, na.rm = TRUE), Age),
    Salary = ifelse(Salary > quantile(Salary, 0.75) + 1.5 * IQR(Salary), NA, Salary)
  ) %>%
  na.omit() %>%
  mutate(Join_Date = as.Date(Join_Date)) %>%
  mutate(Name = str_trim(Name)) %>%
  mutate(Name = str_replace_all(Name, "[^a-zA-Z]", ""))
cleaned_data
我新建了一个杂乱无章的数据集,清洗这个数据集。
总结:
数据清洗是分析的起点,虽然复杂但有规律可循。本文通过具体的案例,展示了R语言中常见的数据清洗方法和技巧,希望能为你的分析工作带来帮助。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-01-13,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号