实现 Apache Kafka 与 Elasticsearch 数据摄取和索引的无缝集成
原创
实现 Apache Kafka 与 Elasticsearch 数据摄取和索引的无缝集成
原创
点火三周
发布于 2024-12-25 18:44:19
发布于 2024-12-25 18:44:19
如何将 Apache Kafka 与 Elasticsearch 集成进行数据摄取和索引
在本文中,我们将展示如何将 Apache Kafka 与 Elasticsearch 集成,以进行数据摄取和索引。我们将概述 Kafka 的生产者和消费者的概念,并创建一个日志索引,通过 Apache Kafka 接收和索引消息。该项目使用 Python 实现,代码可在 GitHub 上找到。
前提条件
- Docker 和 Docker Compose:请确保在您的机器上安装了 Docker 和 Docker Compose。
- Python 3.x:用于运行生产者和消费者脚本。
Apache Kafka 简介
Apache Kafka 是一个分布式流处理平台,具有高可扩展性、可用性和容错性。在 Kafka 中,数据管理通过以下主要组件进行:
- Broker:负责在生产者和消费者之间存储和分发消息。
- Zookeeper:管理和协调 Kafka 的 Broker,控制集群的状态、分区领导者和消费者信息。
- Topics:发布和存储数据以供消费的通道。
- Consumers 和 Producers:生产者将数据发送到 topics,消费者则从中检索数据。

Apache Kafka 结构图
这些组件协同工作,形成了 Kafka 生态系统,为数据流处理提供了一个强大的框架。
项目结构
为了理解数据摄取过程,我们将其分为几个阶段:
- 基础设施配置:设置 Docker 环境以支持 Kafka、Elasticsearch 和 Kibana。
- 生产者创建:实现 Kafka 生产者,将数据发送到日志 topic。
- 消费者创建:开发 Kafka 消费者,读取并将消息索引到 Elasticsearch。
- 摄取验证:验证和确认发送和消费的数据。
使用 Docker Compose 配置基础设施
我们使用 Docker Compose 来配置和管理所需的服务。下面是 Docker Compose 配置文件的代码,该文件设置了 Apache Kafka、Elasticsearch 和 Kibana 的集成所需的每个服务,确保数据摄取过程顺利进行。
version: "3"
services:
  zookeeper:
    image: confluentinc/cp-zookeeper:latest
    container_name: zookeeper
    environment:
      ZOOKEEPER_CLIENT_PORT: 2181
  kafka:
    image: confluentinc/cp-kafka:latest
    container_name: kafka
    depends_on:
      - zookeeper
    ports:
      - "9092:9092"
      - "9094:9094"
    environment:
      KAFKA_BROKER_ID: 1
      KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://kafka:29092,PLAINTEXT_HOST:${HOST_IP}:9092
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: PLAINTEXT:PLAINTEXT,PLAINTEXT_HOST:PLAINTEXT
      KAFKA_INTER_BROKER_LISTENER_NAME: PLAINTEXT
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.15.1
    container_name: elasticsearch-8.15.1
    environment:
      - node.name=elasticsearch
      - xpack.security.enabled=false
      - discovery.type=single-node
      - "ES_JAVA_OPTS=-Xms512m -Xmx512m"
    volumes:
      - ./elasticsearch:/usr/share/elasticsearch/data
    ports:
      - 9200:9200
  kibana:
    image: docker.elastic.co/kibana/kibana:8.15.1
    container_name: kibana-8.15.1
    ports:
      - 5601:5601
    environment:
      ELASTICSEARCH_URL: http://elasticsearch:9200
      ELASTICSEARCH_HOSTS: '["http://elasticsearch:9200"]'
你可以直接从 Elasticsearch Labs 的 GitHub 仓库中获取该文件。
使用 Kafka 生产者发送数据
生产者负责将消息发送到日志 topic。通过批量发送消息,可以提高网络使用效率,并通过 batch_size 和 linger_ms 设置优化批量的数量和延迟。配置 acks='all' 确保消息被持久存储,这对重要的日志数据至关重要。
from kafka import KafkaProducer
import json
import random
import time
import logging

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

producer = KafkaProducer(
    bootstrap_servers=['localhost:9092'],
    value_serializer=lambda x: json.dumps(x).encode('utf-8'),
    batch_size=16384,
    linger_ms=10,
    acks='all'
)

def generate_log_message():
    levels = ["INFO", "WARNING", "ERROR", "DEBUG"]
    messages = [
        "User login successful",
        "User login failed",
        "Database connection established",
        "Database connection failed",
        "Service started",
        "Service stopped",
        "Payment processed",
        "Payment failed"
    ]
    log_entry = {
        "level": random.choice(levels),
        "message": random.choice(messages),
        "timestamp": time.time()
    }
    return log_entry

def send_log_batches(topic, num_batches=5, batch_size=10):
    for i in range(num_batches):
        logger.info(f"Sending batch {i + 1}/{num_batches}")
        for _ in range(batch_size):
            log_message = generate_log_message()
            producer.send(topic, value=log_message)
        producer.flush()

if __name__ == "__main__":
    topic = "logs"
    send_log_batches(topic)
    producer.close()
启动生产者后,消息会批量发送到 topic,如下所示:
INFO:kafka.conn:Set configuration …
INFO:log_producer:Sending batch 1/5
INFO:log_producer:Sending batch 2/5
INFO:log_producer:Sending batch 3/5
INFO:log_producer:Sending batch 4/5
使用 Kafka 消费者进行数据消费和索引
消费者设计用于高效处理消息,从日志 topic 中批量消费并将其索引到 Elasticsearch。通过 auto_offset_reset='latest',确保消费者从最新的消息开始处理,忽略旧消息;max_poll_records=10 限制批次中的消息数为 10 条;fetch_max_wait_ms=2000 使消费者最多等待 2 秒以积累足够的消息,然后再处理批次。
在其主循环中,消费者消费日志消息,处理并将每个批次索引到 Elasticsearch,确保连续的数据摄取。
from kafka import KafkaConsumer
import json
from elasticsearch import Elasticsearch, helpers

consumer = KafkaConsumer(
    'logs',
    bootstrap_servers=['localhost:9092'],
    auto_offset_reset='latest',
    enable_auto_commit=True,
    group_id='log_consumer_group',
    max_poll_records=10,
    fetch_max_wait_ms=2000
)

es = Elasticsearch()

def create_bulk_actions(logs):
    for log in logs:
        yield {
            "_index": "logs",
            "_source": {
                'level': log['level'],
                'message': log['message'],
                'timestamp': log['timestamp']
            }
        }

if __name__ == "__main__":
    try:
        print("Starting message processing…")
        while True:
            messages = consumer.poll(timeout_ms=1000)
            for _, records in messages.items():
                logs = [json.loads(record.value) for record in records]
                bulk_actions = create_bulk_actions(logs)
                response = helpers.bulk(es, bulk_actions)
                print(f"Indexed {response[0]} logs.")
    except Exception as e:
        print(f"Error: {e}")
    finally:
        consumer.close()
        print("Finish")
在 Kibana 中可视化数据
使用 Kibana,我们可以探索和验证从 Kafka 摄取并索引到 Elasticsearch 的数据。通过访问 Kibana 的 Dev Tools,可以查看索引的消息并确认数据是否符合预期。例如,如果我们的 Kafka 生产者发送了 5 个批次,每个批次 10 条消息,那么我们应该在索引中看到总共 50 条记录。
要验证数据,可以在 Dev Tools 部分使用以下查询:
GET /logs/_search
{
  "query": {
    "match_all": {}
  }
}
响应如下:
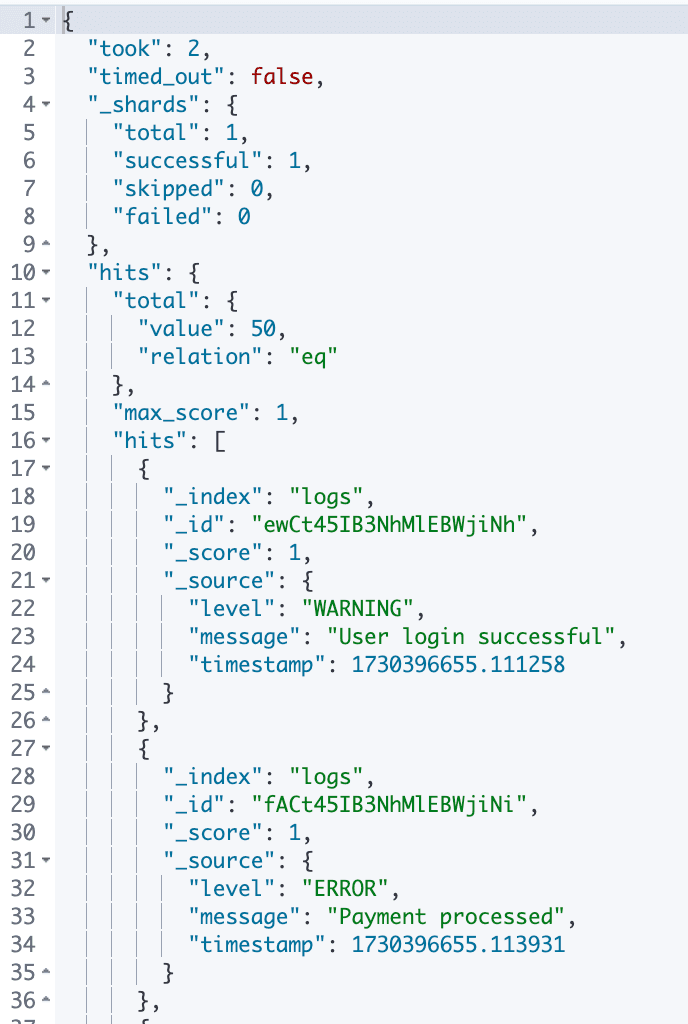
数据验证响应
此外,Kibana 提供了创建可视化和仪表板的功能,帮助我们直观地分析数据。下图展示了一些我们创建的仪表板和可视化示例,以多种格式展示数据,从而增强对处理信息的理解。
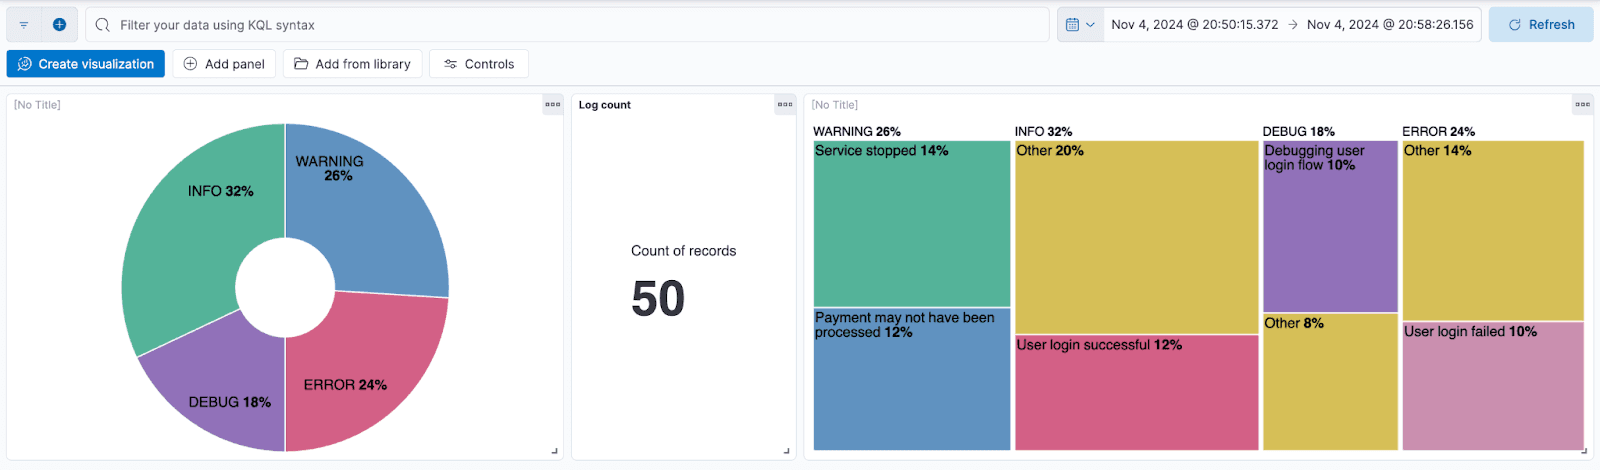
Kibana 可视化
使用 Kafka Connect 进行数据摄取
Kafka Connect 是一个旨在简化数据源和目标(如数据库或文件系统)之间集成的服务。它使用预定义的连接器自动处理数据移动。在我们的案例中,Elasticsearch 作为数据接收端。
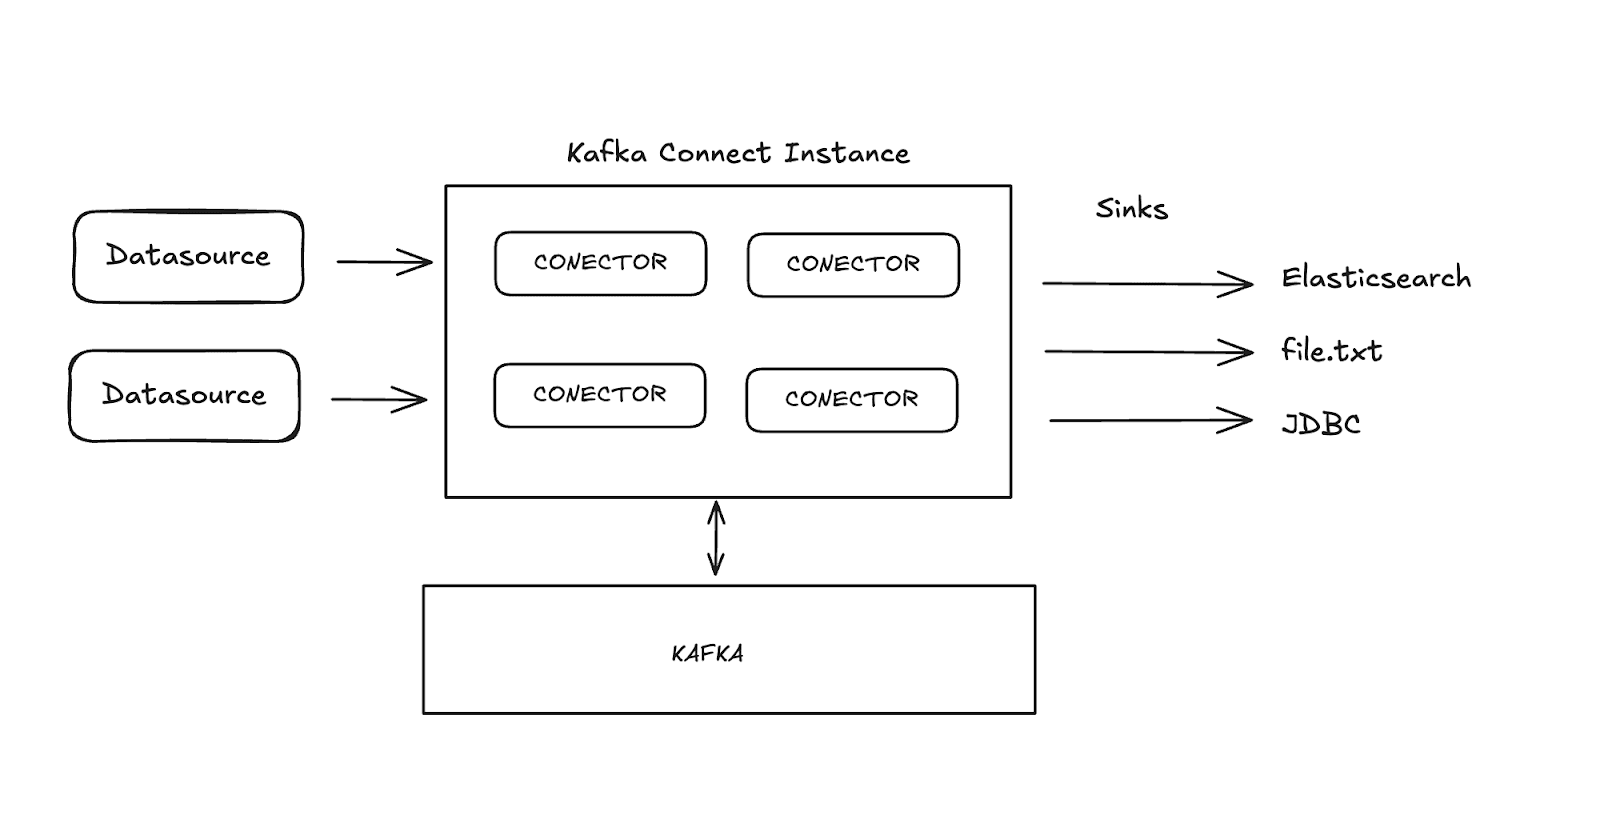
使用 Kafka Connect 进行数据摄取
使用 Kafka Connect,我们可以简化数据摄取过程,无需手动实现数据摄取工作流到 Elasticsearch。通过适当的连接器,Kafka Connect 允许发送到 Kafka topic 的数据直接索引到 Elasticsearch,设置简单,不需要额外的编码。
使用 Kafka Connect
为了实现 Kafka Connect,我们将在 Docker Compose 设置中添加 kafka-connect 服务。该配置的关键部分是安装 Elasticsearch 连接器,该连接器将处理数据索引。
配置服务并创建 Kafka Connect 容器后,需要一个 Elasticsearch 连接器的配置文件。该文件定义了关键参数,如:
connection.url:Elasticsearch 的连接 URL。topics:连接器将监控的 Kafka topic(在本例中为 "logs")。type.name:Elasticsearch 中的文档类型(通常为 _doc)。value.converter:将 Kafka 消息转换为 JSON 格式。value.converter.schemas.enable:指定是否应包含模式。schema.ignore和key.ignore:在索引时忽略 Kafka 模式和键的设置。
下面是创建 Elasticsearch 连接器的 curl 命令:
curl --location '{{url}}/connectors' \
--header 'Content-Type: application/json' \
--data '{
    "name": "elasticsearch-sink-connector",
    "config": {
        "connector.class": "io.confluent.connect.elasticsearch.ElasticsearchSinkConnector",
        "topics": "logs",
        "connection.url": "http://elasticsearch:9200",
        "type.name": "_doc",
        "value.converter": "org.apache.kafka.connect.json.JsonConverter",
        "value.converter.schemas.enable": "false",
        "schema.ignore": "true",
        "key.ignore": "true"
    }
}'
通过这种配置,Kafka Connect 将自动开始摄取发送到 "logs" topic 的数据并将其索引到 Elasticsearch。此方法允许完全自动化的数据摄取和索引,无需额外的编码,从而简化了整个集成过程。
结论
将 Kafka 和 Elasticsearch 集成创建了一个强大的实时数据摄取和分析管道。本指南提供了构建稳健数据摄取架构的基础方法,结合 Kibana 的无缝可视化和分析,准备好适应未来更复杂的需求。
此外,使用 Kafka Connect 使 Kafka 和 Elasticsearch 之间的集成更加简化,消除了处理和索引数据所需的额外代码。Kafka Connect 使发送到特定 topic 的数据能够自动索引到 Elasticsearch,配置简单。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号