为什么出现Transformer:传统RNN的问题;Attention(注意力机制)和Self-Attention(自注意力机制)区别
原创
为什么出现Transformer:传统RNN的问题;Attention(注意力机制)和Self-Attention(自注意力机制)区别
原创
zhangjiqun
发布于 2024-11-19 08:37:38
发布于 2024-11-19 08:37:38
推荐文章:深入探索MyBatis-Plus:高效实现字段模糊查询的秘诀-腾讯云开发者社区-腾讯云
这篇文章深入探讨MyBatis-Plus在模糊查询方面的应用,从基础用法到高级技巧,再到性能优化与安全注意事项,旨在帮助开发者全面掌握并有效利用MyBatis-Plus进行模糊查询操作。整体内容全面,步骤清晰,非常适合读者学习和参考。
目录
Attention(注意力机制)和Self-Attention(自注意力机制)区别
为什么出现Transformer:传统RNN的问题
解码器的输入依赖编码器的输出
编码器的输出无论输入数据有多少内容最后的输出结果都是固定长度的向量,这样当输入内容比较多的时候,就会丢失很多关键信息,导致最后效果出现偏差
假设我们有一个简单的机器翻译任务,需要将英文句子翻译成中文。
英文句子:The quick brown fox jumps over the lazy dog.
中文翻译:敏捷的棕色狐狸跳过懒惰的狗。
在Seq2Seq模型中,通常有一个编码器和一个解码器。
- 编码器:它的任务是将输入的英文句子编码成一个固定长度的向量。这个向量应该能够捕捉到输入句子的所有关键信息,比如主语、谓语、宾语以及它们之间的关系。但是,如果输入句子很长,包含很多信息,而编码器的输出向量长度是固定的,那么就有可能无法完全捕捉到所有关键信息。比如,在上述英文句子中,“quick”和“brown”是描述“fox”的形容词,但如果编码器的输出向量长度不够,就有可能无法准确捕捉到这两个形容词的信息。
- 解码器:它的任务是根据编码器的输出向量,逐步生成中文翻译。在每一步中,解码器都会根据当前的上下文(包括之前已经生成的翻译和编码器的输出向量)来决定下一个应该生成的词。但是,如果编码器的输出向量丢失了关键信息,那么解码器就有可能无法生成准确的翻译。比如,如果编码器的输出向量没有捕捉到“quick”和“brown”的信息,那么解码器就有可能无法生成“敏捷的棕色”这个描述。
信息丢失的后果
当编码器无法将所有关键信息都编码到固定长度的向量中时,就会导致信息丢失。这种信息丢失可能会导致解码器无法生成准确的翻译,或者生成与原文意思不符的翻译。比如,在上述例子中,如果“quick”和“brown”的信息丢失了,那么解码器可能会生成“狐狸跳过狗”这样的不准确的翻译,而不是“敏捷的棕色狐狸跳过懒惰的狗”。
为了解决这个问题,研究人员提出了多种方法,比如注意力机制(Attention Mechanism)。注意力机制允许解码器在生成每个词时,都能够关注输入句子的不同部分,并动态地选择最相关的信息。这样,即使输入句子很长,解码器也能够准确地捕捉到所有关键信息,并生成准确的翻译。
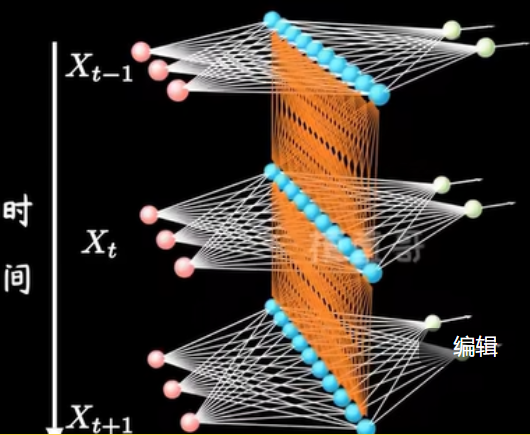
Rnn是顺序执行的效率不高:顺序执行
Attention(注意力机制)和Self-Attention(自注意力机制)区别
在深度学习领域,特别是在自然语言处理和计算机视觉等任务中,扮演着重要角色。以下是两者的主要区别:
一、计算对象不同
- Attention:通常指的是source对target的attention,即源序列对目标序列的注意力。在传统的encoder-decoder模型中,attention机制用于提升模型对输入序列(source)和输出序列(target)之间关系的理解能力。它帮助模型在生成每个输出时,能够关注输入序列中的不同部分,从而更准确地生成与输入相关的输出。
- Self-Attention:指的是source对source的attention,即序列内部不同位置之间的注意力。它允许模型在处理输入序列时,能够同时考虑整个序列的信息,并计算序列中每个元素与其他元素之间的相似度(或称为注意力分数)。这种机制打破了传统序列模型(如RNN、LSTM)中信息只能单向或双向流动的限制。
二、应用场景不同
- Attention:更常用于需要处理两个不同序列之间关系的任务,如机器翻译中的source和target句子之间的关系。它帮助模型在翻译过程中,能够准确地理解源句子的含义,并生成与目标语言相对应的翻译。
- Self-Attention:可应用于单个网络,是RNN和CNN的特殊情况。它广泛应用于自然语言处理任务(如机器翻译、文本分类)中,是Transformer等先进模型的核心组件。Self-Attention机制使模型能够同时看到整个输入序列,从而捕捉到更丰富的上下文信息,并支持并行计算,大大提高了处理速度。
三、功能差异
- Attention:主要功能是告诉每个部分的重要程度,即根据任务需求,为输入序列中的每个部分分配不同的注意力权重,从而突出重要信息并抑制无关信息。
- Self-Attention:主要功能是揭示各个部分的关联关系,即计算序列中每个元素与其他元素之间的相似度,并根据这些相似度对序列进行加权求和,从而捕捉到序列内部的复杂结构和依赖关系。
综上所述,Attention和Self-Attention在计算对象、应用场景和功能方面存在显著差异。Attention更侧重于处理两个不同序列之间的关系,而Self-Attention则更关注序列内部不同位置之间的相关性。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号