可视化—Upset图绘制
原创
可视化—Upset图绘制
我们在可视化集合之间关系的时候,常常会绘制韦恩图。但随着集合的增多,韦恩图显示的关系会越来越复杂,很难一眼看出其中的信息。这种情况下我们需要使用 UpSetR 包来反映集合间的关系。
1 数据导入
把你需要展示的集合做成一个list即可,我这里是需要展示的集合存在各个Rdata中,故用下述代码导入该文件夹中所有的Rdata数据。
rm(list=ls())
#install.packages("UpSetR")
library(UpSetR)

## 数据导入
#设置文件路径
file_path <- "../Rdata/"
#列出所有以 .Rdata 结尾的文件
rdata_files <- list.files(file_path, pattern = "\\.Rdata$")

#依次加载每个文件
for (file in rdata_files) {
  load(file.path(file_path, file))
}

##需要展示的向量形成一个集合
input_list <- list(
  DC_HAO_pro_dif_all = DC_HAO_pro_dif_all,
  FE_HAO_pro_dif_all = FE_HAO_pro_dif_all,
  DC_HAO_trans_dif_all = DC_HAO_trans_dif_all,
  FE_HAO_trans_dif_all = FE_HAO_trans_dif_all,
  DC_exo_dif_all = DC_exo_dif_all,
  FE_exo_dif_all = FE_exo_dif_all
)
2 基本绘制
采用三段法进行图片的保存与绘制
#绘图
# 保存
png("../Table+figure/upset_plot.png", width = 1000, height = 800, res = 150)
UpSetR::upset(
  fromList(input_list),
  order.by = "freq",
  nsets = length(input_list),  # 显示所有集合
  nintersects = NA   #显示所有交集
)
dev.off()  # 关闭 PDF 设备
3 拓展
参考链接https://zhuanlan.zhihu.com/p/370210775
1.可以指定参数,来调整图形属性
例如,使用 number.angles 来设置柱状图柱子上方数字的倾斜角度;使用 point.size 和 line.size 来设置矩阵点图中点和线的大小;mainbar.y.label和 sets.x.label 可以设置柱状图和条形图的轴标签;text.scale 包含6 个值,用于指定图上所有文本标签的大小。
text.scale 参数值的顺序为:
- 柱状图的轴标签和刻度
- 条形图的轴标签和刻度
- 集合名称
- 柱子上方表示交集大小的数值
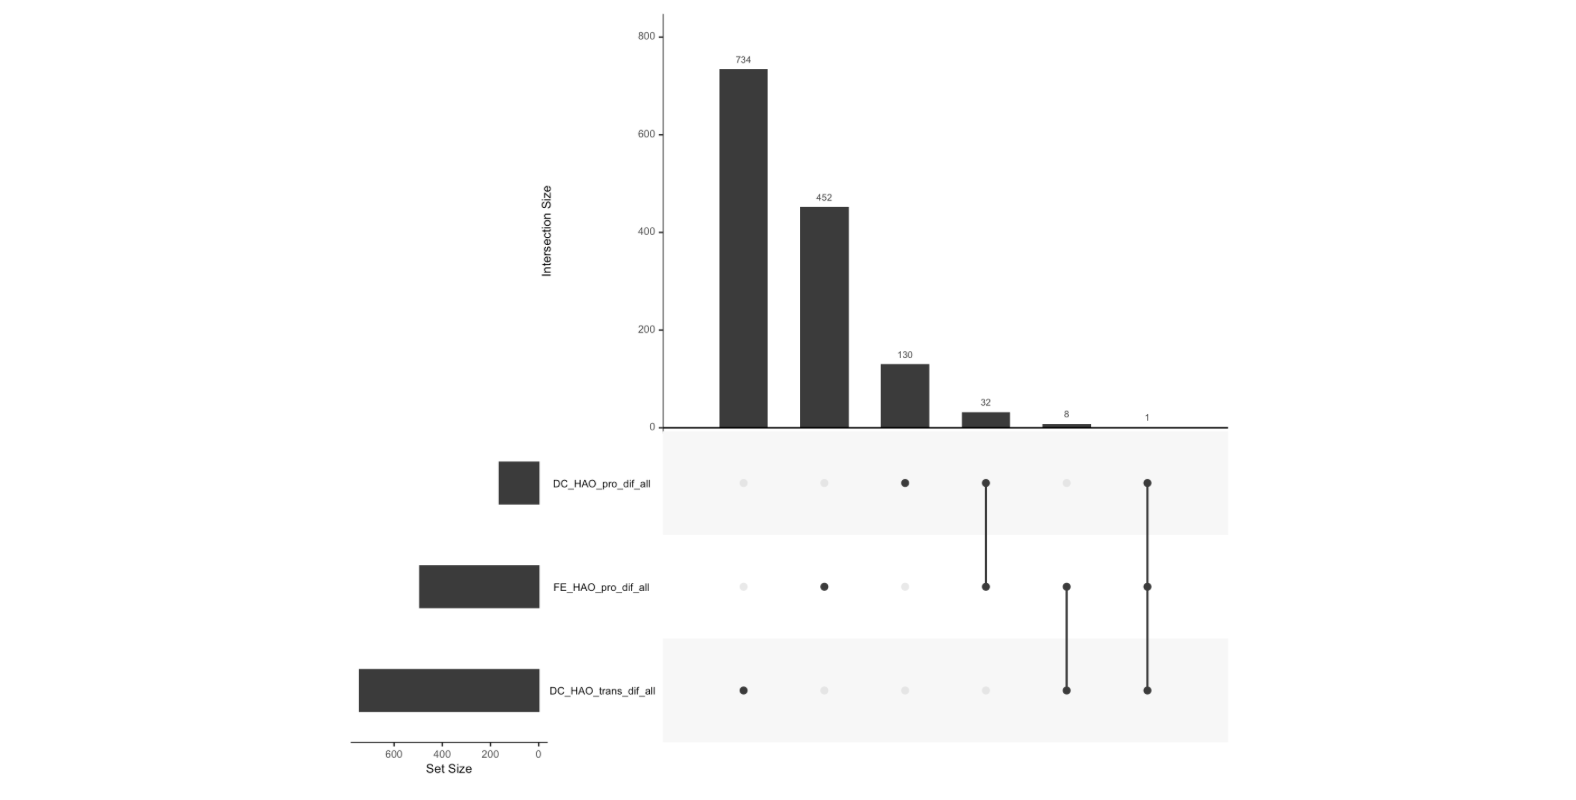
2.展示所需要的集合
upset(fromList(input_list),
      sets = c("DC_HAO_pro_dif_all", "FE_HAO_pro_dif_all", "DC_HAO_trans_dif_all"),
      #mb.ratio 用于控制上下图形所占比例
      mb.ratio = c(0.55, 0.45)
      )
3.排序
3.1对交集大小进行排序
通过置 order.by 参数,来对交集进行排序
freq默认是升序,可以使用 decreasing = TRUE 让其降序排列
upset(fromList(input_list),
      sets = c("DC_HAO_pro_dif_all", "FE_HAO_pro_dif_all", "DC_HAO_trans_dif_all"),
      mb.ratio = c(0.55, 0.45),
      order.by = "freq",
      decreasing = FALSE
      )
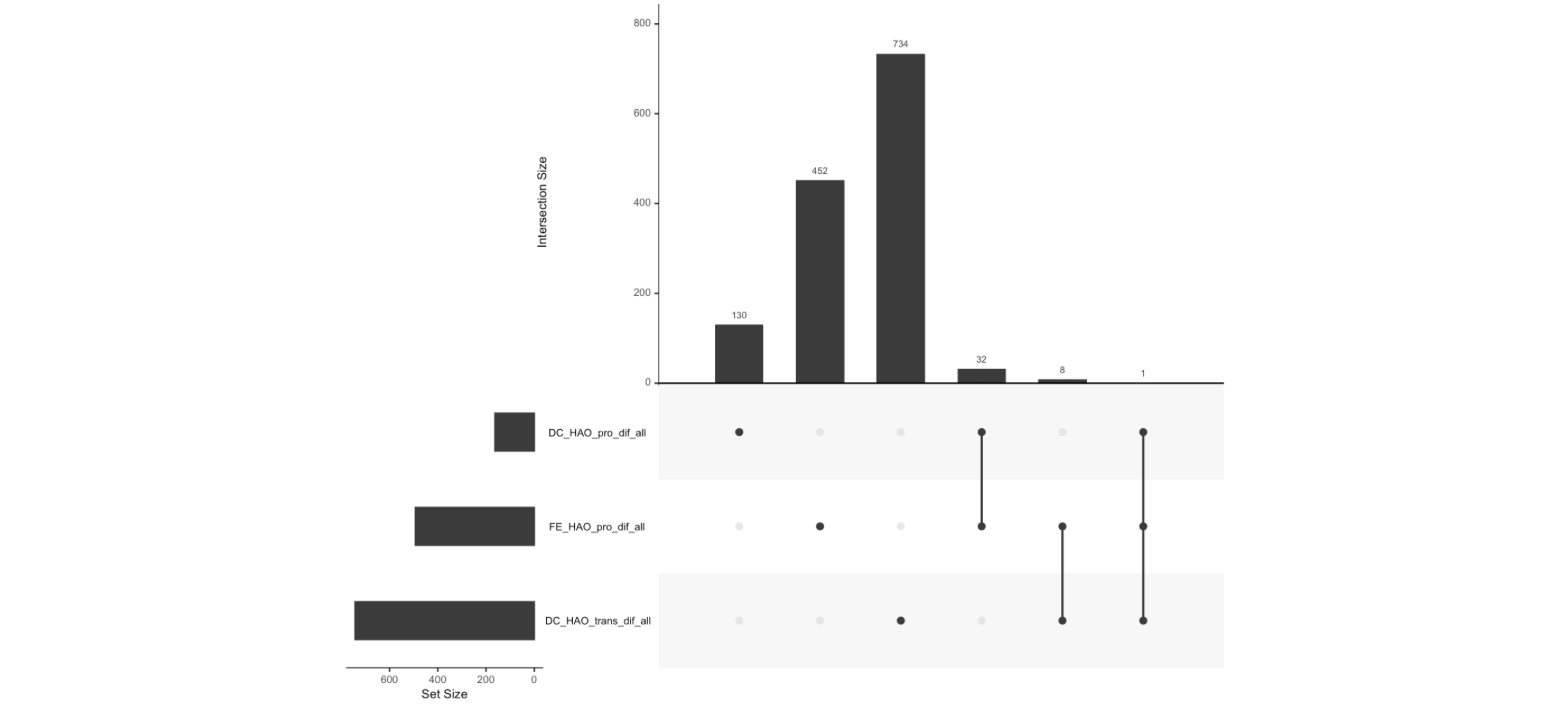
3.2 按照集合大小排序
使用order.by = "degree",参数,degree 默认为降序排序,设置 decreasing = FALSE 使其升序排列
upset(fromList(input_list),
      sets = c("DC_HAO_pro_dif_all", "FE_HAO_pro_dif_all", "DC_HAO_trans_dif_all"),
      mb.ratio = c(0.55, 0.45),
      order.by = "degree",
      decreasing = FALSE
      )
3.3 同时指定freq,degree顺序
upset(fromList(input_list),
      sets = c("DC_HAO_pro_dif_all", "FE_HAO_pro_dif_all", "DC_HAO_trans_dif_all"),
      mb.ratio = c(0.55, 0.45),
      order.by = c("degree", "freq"),
      decreasing = c(TRUE, FALSE)
      )
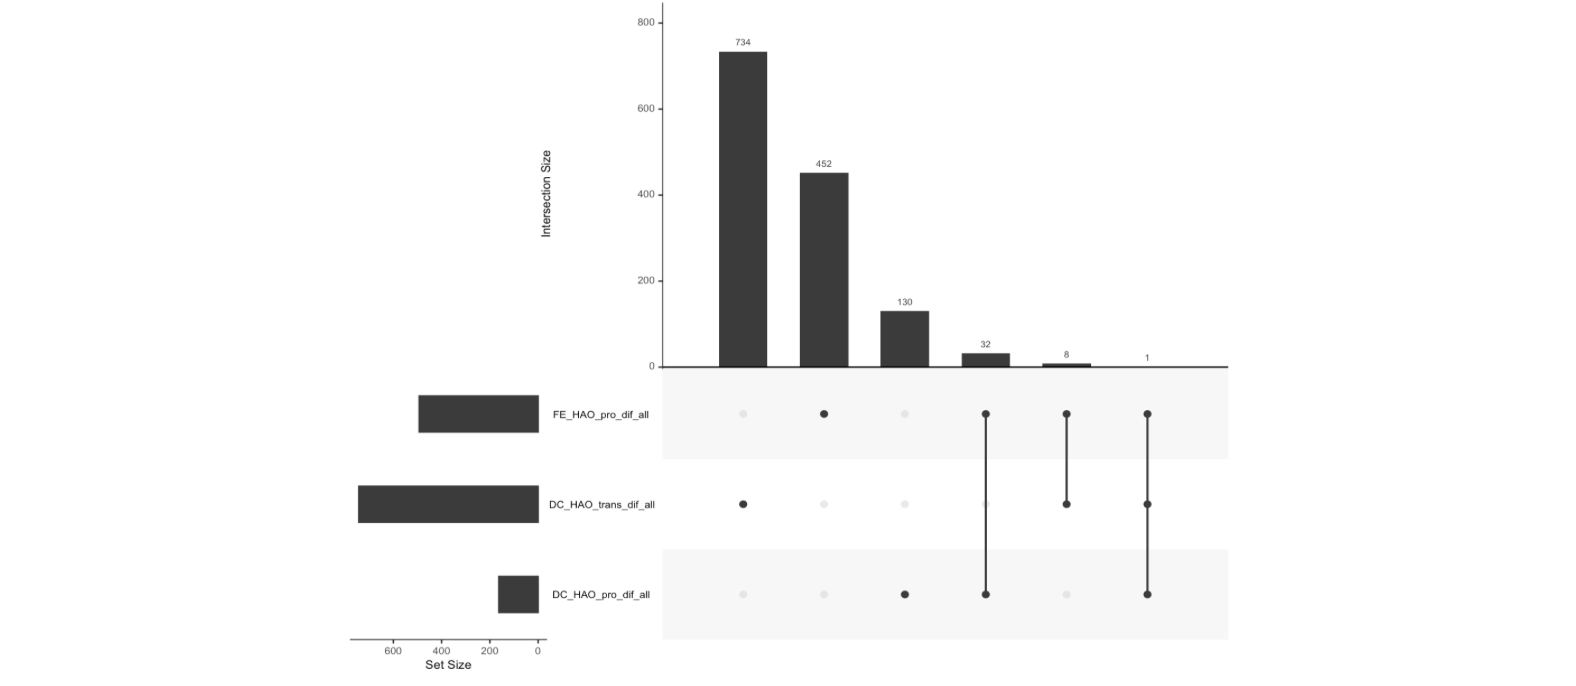
3.4 让集合按照 sets 参数中指定的出现的顺序排列
通过设置keep.order = TRUE参数
如果想要显示交集为空的组合,可以设置 empty.intersections = “on” 参数
upset(fromList(input_list),
      sets = c("DC_HAO_pro_dif_all", "DC_HAO_trans_dif_all","FE_HAO_pro_dif_all"),
      mb.ratio = c(0.55, 0.45),
      keep.order = TRUE
      )
4 查询
查询通过 queries 参数来执行,接受一个嵌套的 list 来表示多个查询条件,每个查询条件包含四个字段:
query:需要执行的查询
params:查询参数列表
color:设置满足查询条件的元素在图中的颜色
active:如果为 TRUE,柱状图颜色将会被覆盖,为 FALSE 则会在柱子上添加带有随机扰动的点
4.1 内置交集查询
我们使用内置的交集查询:intersects,用来寻找或显示特定的交集,并将找到的交集进行上色
upset(fromList(input_list), queries = list(
  list(
    query = intersects,
    params = list("DC_HAO_trans_dif_all", "FE_HAO_trans_dif_all"),
    color = "orange",
    active = T),
  list(
    query = intersects,
    params = list("FE_HAO_trans_dif_all", "DC_exo_dif_all"),
    color = "red",
    active = T)#list最后一个元素后不能有逗号
)
)
4.2 内置元素查询
upset图,不仅可以传入一个向量列表,还可以传入一个数据框,接下来的演示使用upset包自带的数据进行演示
movies <- read.csv(system.file("extdata", "movies.csv", package = "UpSetR"),
                   header = T, sep = ";")
                   > colnames(movies)
 [1] "Name"        "ReleaseDate" "Action"      "Adventure"   "Children"    "Comedy"
 [7] "Crime"       "Documentary" "Drama"       "Fantasy"     "Noir"        "Horror"
[13] "Musical"     "Mystery"     "Romance"     "SciFi"       "Thriller"    "War"
[19] "Western"     "AvgRating"   "Watches"
使用 elements 来进行元素查询,来展示元素在交集中的分布情况
upset(movies,
      queries = list(
        list(
          query = elements,
          #这里检查 movies 数据集的 AvgRating 列,选出评分在 3.5 和 4.1 之间的电影。
          params = list("AvgRating",  3.5, 4.1),
          color = "blue",
          #表示该查询条件是激活的,会在图形中显示
          active = T),
        list(
          query = elements,
          #查询 ReleaseDate 列,选出发行年份在 1980、1990 或 2000 年的电影
          params = list("ReleaseDate", 1980, 1990, 2000),
          color = "red",
          #该查询条件不激活,因此不会在图形中显示
          active = F)
        )
      )
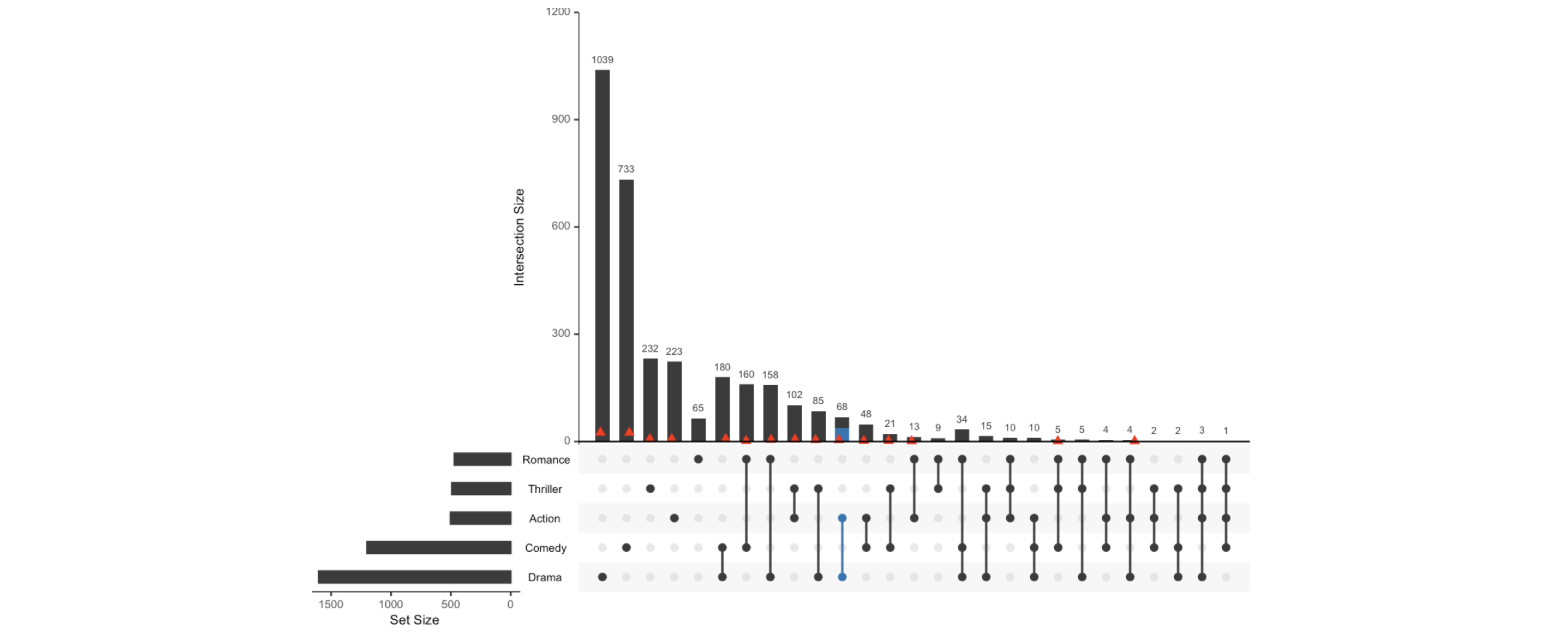
可以为 expression 参数设置过滤表达式来提取查询结果的子集
upset(movies,
      queries = list(
      #第一个查询条件(用于筛选 Action 和 Drama 电影的交集)
        list(
          query = intersects,
          params = list("Action", "Drama"),
          active = T),
          #第二个查询条件(用于筛选 ReleaseDate)指定查询 ReleaseDate 列,
          #选择发行年份在 1980、1990 或 2000 年的电影
        list(
          query = elements,
          params = list("ReleaseDate", 1980, 1990, 2000),
          color = "red",
          active = F)),
      expression = "AvgRating > 3 & Watches > 100"
)
4.3 自定义查询
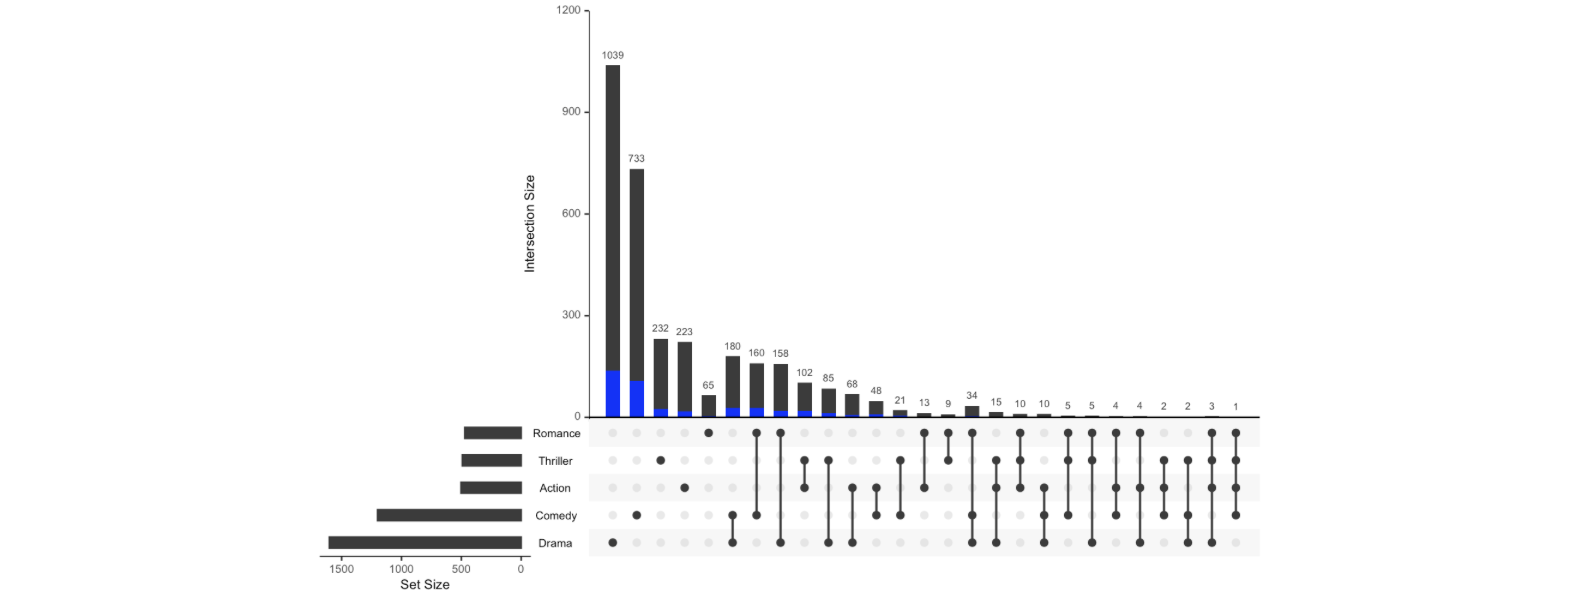
#查询函数会应用于数据的每一行中,我们可以定义如下查询函数
#筛选发行日期在 release 内,且平均评分大于某个值的电影
Myfunc <- function(row, release, rating) {
  data <- (row["ReleaseDate"] %in% release) & (row["AvgRating"] > rating)
}
upset(movies,
      queries = list(
        list(
          query = Myfunc,
          params = list(c(1970, 1980, 1990, 1999, 2000), 2.5),
          color = "blue",
          active = T)
        )
      )
4.4 添加查询图例
使用 query.legend 参数来指定查询图例的位置,top 或bottom
在查询条件中,使用 query.name 来设置查询的名称,如果没设置,会自动生成
upset(movies,
      query.legend = "top",
      queries = list(
        list(
          query = intersects,
          params = list("Drama", "Comedy", "Action"),
          color = "orange", active = T,
          query.name = "Funny action"),
        list(
          query = intersects,
          params = list("Drama"),
          color = "red", active = F),
        list(
          query = intersects,
          params = list("Action", "Drama"),
          active = T,
          query.name = "Emotional action")
        )
      )
5 属性图
属性图
attribute.plots 参数用于执行属性图的绘制,包含 3 个字段:
gridrows:设置属性图的空间大小,UpSet plot 默认为 100 X 100,如果设置为 50,则整个图形变成 150 X 100
plots:图形列表,每个元素包含 4 个参数:
plot:返回 ggplot 对象的函数
x:图形的 x 轴变量
y:图形的 y 轴变量
queries:是否使用已经存在的查询来覆盖绘图数据
5.1 内置绘图函数
5.1.1 使用包中自带的 histogram 函数来绘制直方图
upset(movies,
      main.bar.color = "black",
      queries = list(
        list(
          query = intersects,
          params = list("Drama"),
          active = T)
      ),
      attribute.plots = list(
        gridrows = 50,
        plots = list(
          list(
            plot = histogram,
            x = "ReleaseDate",
            queries = F),
          list(
            plot = histogram,
            x = "AvgRating",
            queries = T)
        ), ncols = 2
      )
)
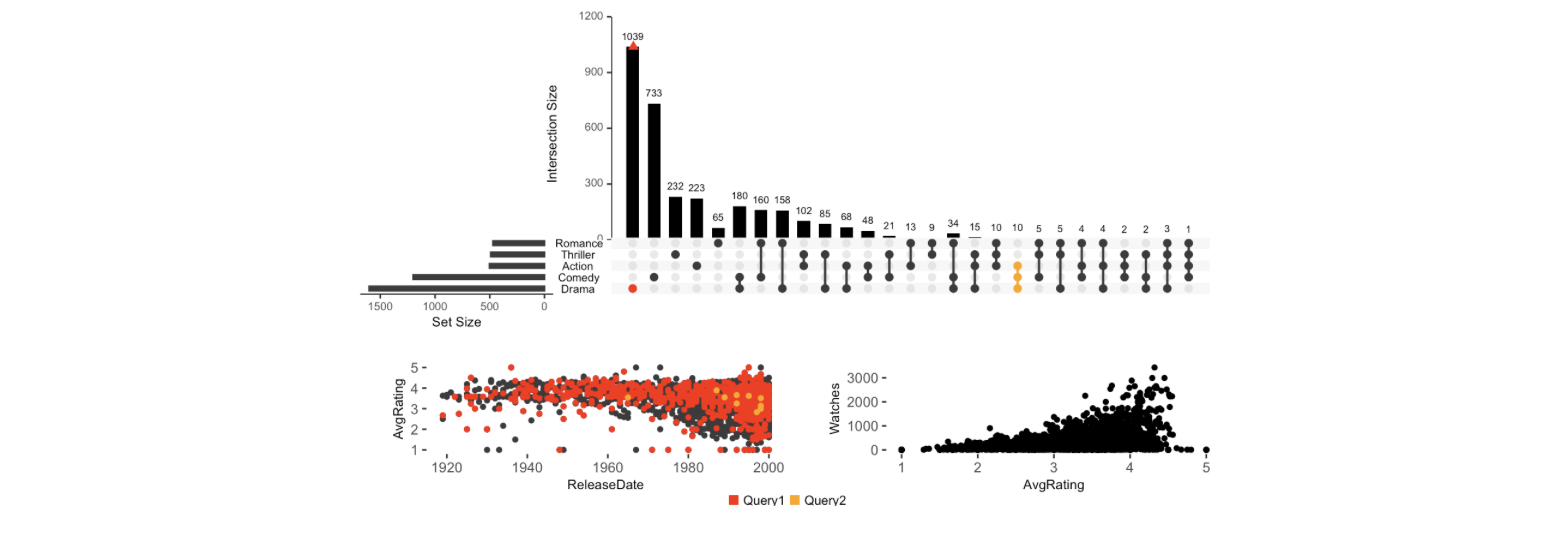
5.1.2 使用包中自带的 scatter_plot 函数来绘制散点图
upset(movies,
      main.bar.color = "black",
      queries = list(
        list(
          query = intersects,
          params = list("Drama"),
          color = "red",
          active = F),
        list(
          query = intersects,
          params = list("Drama", "Comedy", "Action"),
          color = "orange",
          active = T)
      ), attribute.plots = list(
        gridrows = 45,
        plots = list(
          list(
            plot = scatter_plot,
            x = "ReleaseDate",
            y = "AvgRating",
            queries = T),
          list(plot = scatter_plot,
               x = "AvgRating",
               y = "Watches",
               queries = F)
        ),
        ncols = 2),
      query.legend = "bottom"
)
5.1.3 自定义绘图函数
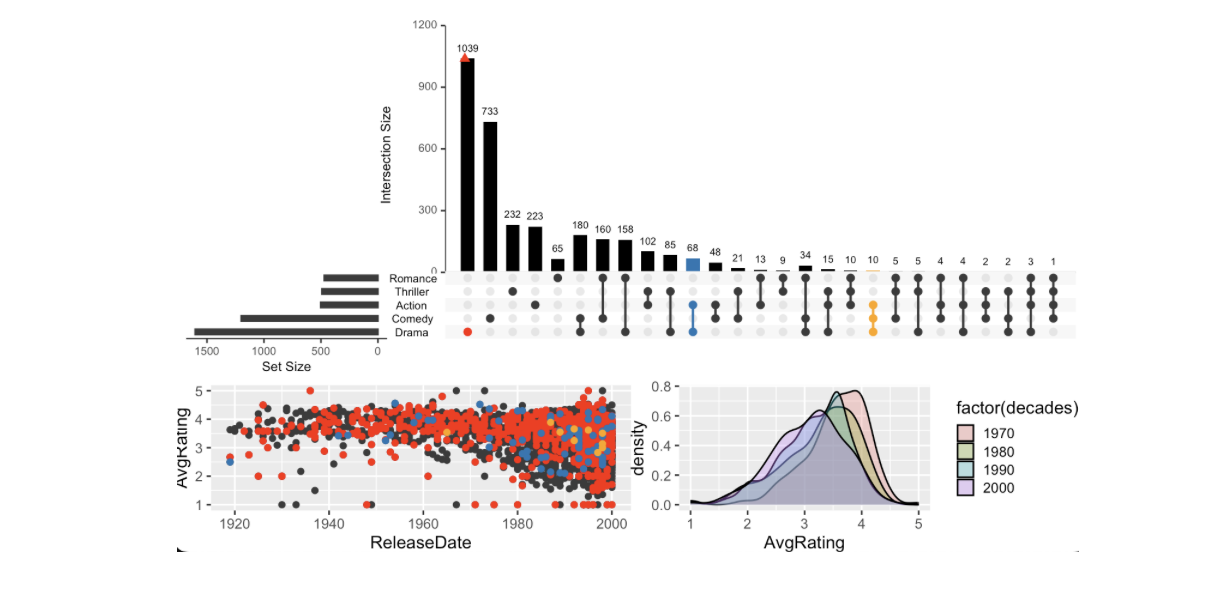
我们先定义两个基于 ggplot2 的函数,用于绘制散点图和密度图
my_scatter <- function(data, x, y) {
  p <- ggplot(data, aes_string(x, y, colour = "color")) +
    geom_point() +
    scale_colour_identity() +
    theme(
      plot.margin = unit(c(0, 0, 0, 0), "cm")
    )
  p
}

my_density <- function(data, x, y) {
  data$decades <- data[, y] %/% 10 * 10
  data <- data[which(data$decades >= 1970), ]
  p <- ggplot(data, aes_string(x)) +
    geom_density(aes(fill = factor(decades)), alpha = 0.3) +
    theme(
      plot.margin = unit(c(0, 0, 0, 0), "cm"),
      legend.key.size = unit(0.4, "cm")
    )
  p
}
然后应用在属性图中
upset(movies,
      main.bar.color = "black",
      queries = list(
        list(
          query = intersects,
          params = list("Drama"),
          color = "red", active = F),
        list(
          query = intersects,
          params = list("Action", "Drama"),
          active = T),list(
          query = intersects,
          params = list("Drama", "Comedy", "Action"),
          color = "orange", active = T)
        ), attribute.plots = list(
        gridrows = 45,
        plots = list(
          list(
            plot = my_scatter,
            x = "ReleaseDate",
            y = "AvgRating",
            queries = T),
          list(
            plot = my_density,
            x = "AvgRating",
            y = "ReleaseDate",
            queries = F)
          ),
        ncols = 2)
      )
5.1.4 绘制箱线图
想要绘制箱线图,可以使用 boxplot.summary 参数,最多只能同时绘制两个变量的箱线图。
upset(movies, boxplot.summary = c("AvgRating", "ReleaseDate"))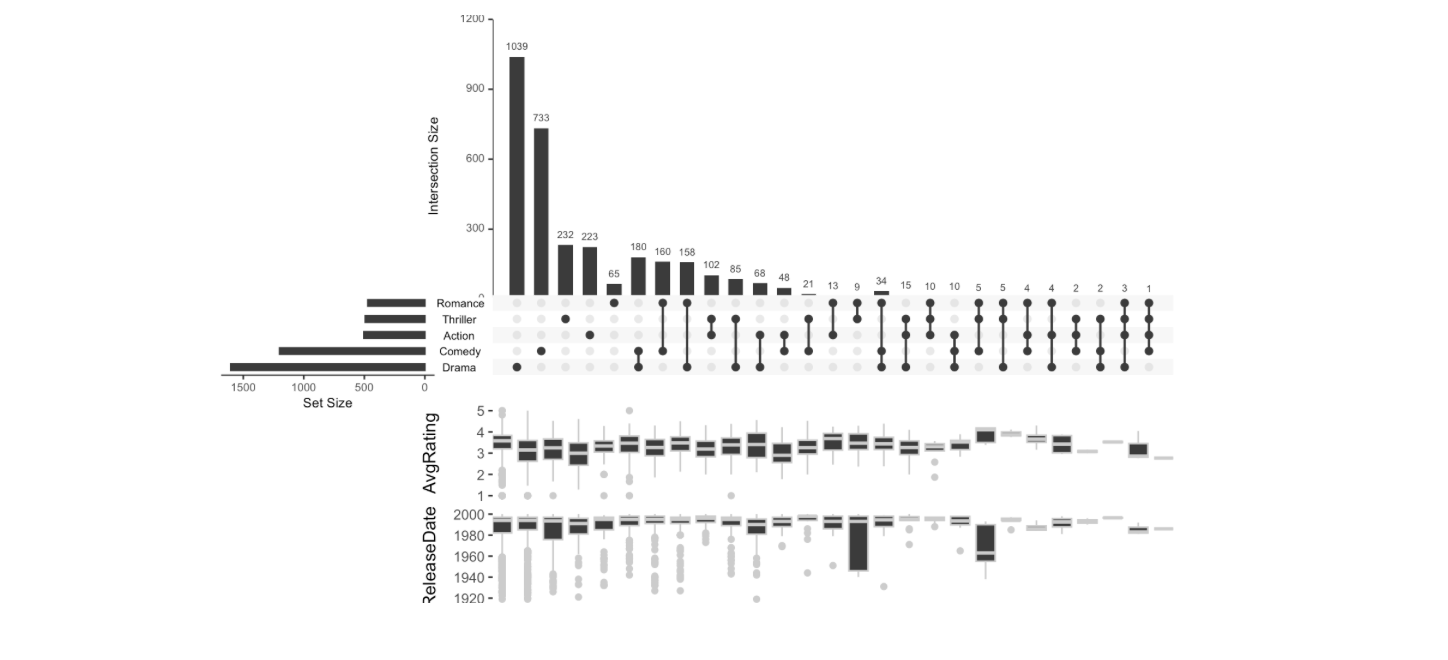
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号