动态三维高斯:通过持续动态视图合成进行跟踪


来源:arxiv 论文题目:Dynamic 3D Gaussians: Tracking by Persistent Dynamic View Synthesis 项目链接:https://github.com/JonathonLuiten/Dynamic3DGaussians 作者:Luiten, Jonathon and Kopanas, Georgios and Leibe, Bastian and Ramanan, Deva. 内容整理:陈梓煜 简介:本文提出了一种创新性的动态3D场景建模方法,将高斯溅射技术扩展到动态场景。通过使用定向粒子表示,该方法能够准确地重建场景的位置、颜色和运动,并结合物理先验进行正则化。与先前方法相比,该方法实现了无需光流或姿态信息的逐帧渲染的追踪,具有良好的可解释性和实时性。该方法在动态场景重建、密集 6-DOF 场景追踪和新视角生成等任务上取得了出色的性能,为创造性的场景编辑和应用提供了广泛的可能性。
介绍
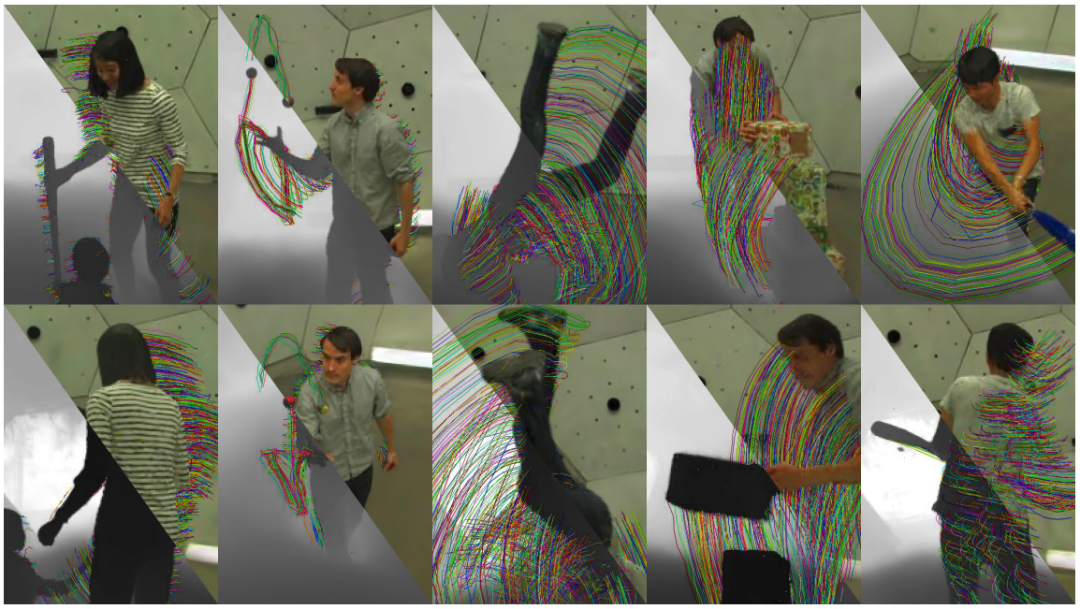
图 1
动态3D世界建模将对判别式和生成式人工智能产生变革性影响。在判别式方面,这将实现对场景每一部分随时间变化的度量空间重建。模拟一切当前的位置、过去的位置及其移动方向,对许多应用至关重要。在生成式人工智能中,这样的模型可以实现诸如轻松控制和编辑高分辨率动态3D资源等新形式的内容创作,用于电影、视频游戏或元宇宙。许多此类应用需要可扩展的方法,能够实时处理高分辨率图像。到目前为止,还没有方法能够实现对任意动态场景的逼真重建,同时具备高度精确的追踪和视觉上吸引人的新视角,而且能够快速训练并实时渲染。
在本文中我们提出了这样一种方法,同时解决动态3D场景重建和密集非刚性六自由度(6-DOF)场景追踪的判别任务,以及动态新视角合成的生成任务。我们构建了一个与所有输入观测数据(不同时间步骤和摄像机的图像)一致的动态3D表示,并从中正确建模基础场景,带有物理正确的空间一致性先验,以此产生追踪。
3D高斯溅射(Gaussian Splatting)最近已经成为对3D静态场景建模领域火热的方法。它通过溅射式光栅化,将复杂场景表示为大量彩色3D高斯的组合,并将其渲染到相机视图中。然后,可以通过可微分渲染和基于梯度的优化调整这些高斯的位置、大小、旋转、颜色和不透明度,使其代表一组输入图像给出的3D场景。在本文中,我们将此方法从仅模拟静态场景扩展到动态场景。
我们将高斯的所有属性(如数量、颜色、不透明度和大小)限制在时间上保持不变,但允许它们的位置和方向变化。这使我们的高斯可以被视为世界的基于粒子的物理模型,其中定向粒子随时间进行刚体转换。为了从原始摄像机图像重建这些粒子,我们利用了在任何时候,它们都可以高效地被溅射到任何摄像机视点的属性,从而可以用图像重建损失进行优化
关键的是,粒子使我们能够使用物理先验,用于优化过程的正则化:局部刚性先验、局部旋转相似性先验和长期局部等距先验。这些先验确保局部粒子邻域在时间步骤间大致刚性移动,并且在所有时间步骤中相邻粒子保持接近。
先前对动态场景的神经重建方法可以被视为要么是欧拉式表示,在固定网格位置跟踪场景运动,要么是拉格朗日式表示,其中观察者跟随特定粒子穿越空间和时间。我们属于后者,但与以前基于点的表示不同,我们使用了允许更丰富物理先验(如上所述)并且直接重建所有3D点的六自由度(6-DOF)运动的定向粒子,从而启用各种下游应用(见图2)。
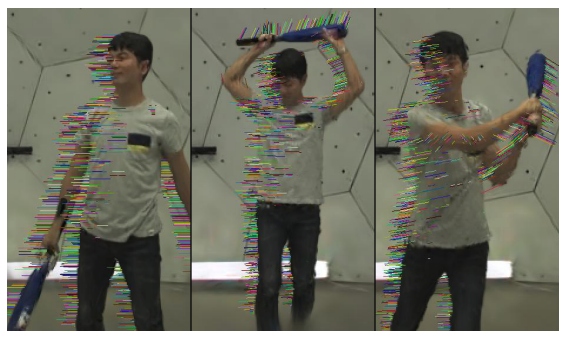
图 2
我们方法的一个显著特点是,追踪仅仅来自于逐帧图像的渲染过程。没有输入光流、姿态骨架或任何其他形式的对应信息。由于其自然可分解的性质,动态3D高斯对许多创意场景编辑技术自然适用,例如在所有时间步骤上传播编辑,向场景中添加或移除动态对象,或让摄像机跟随场景元素,如图3所示。此外,极快的渲染和训练时间使它们比以前的动态重建方法更易于使用,并支持实时渲染应用。
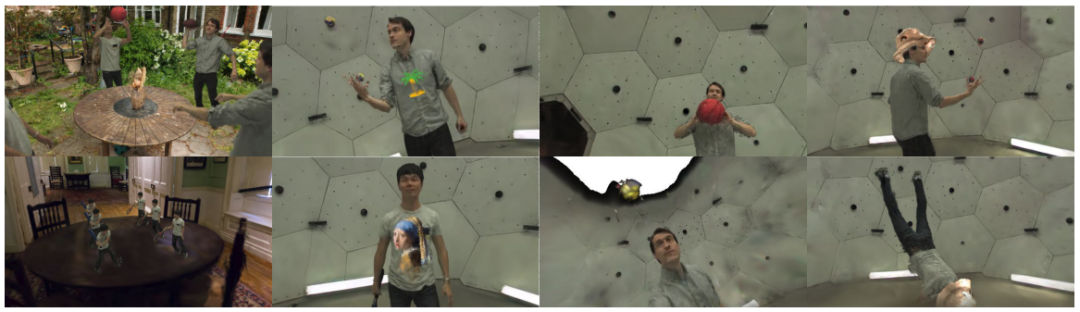
图 3
方法
概述
给定一组来自不同时间步和不同摄像机的图像(
),以及每个摄像机的内参(
)和外参(
)矩阵,我们的方法重建这些摄像机观察到的动态三维场景(
)。
除了测试场景,没有使用额外的训练数据。重建是在时间上在线进行的,即每次都会重建场景的一个时间步,每次初始化都使用前一个时间步的表示。第一个时间步作为我们场景的初始化,我们优化所有属性,然后对于后续的时间步,除了定义场景运动的属性外,所有属性都保持不变。每个时间步都通过可微分渲染器(
)使用梯度优化进行训练,以在每个时间步将场景渲染到每个训练摄像机中。
渲染
与输入图像
进行比较,并通过自动微分迭代更新
的参数,以减小
和
之间的误差。收敛后,表示
是给定训练摄像机
的每个时间步的场景的三维重建。通过选择适当的
表示,并在优化过程中应用基于物理的正则化损失,我们可以确保所有的
在时间上与彼此一致,并且在每个时间步存在每个3D点及其相应3D旋转变化之间的一一对应关系。
动态三维高斯
我们的动态场景表示(
)由一组动态三维高斯参数化,每个高斯具有以下参数:
- 每个时间戳下的高斯3D中心 (
,
,
).
- 每个时间戳下的旋转参数 (
,
,
,
).
- 所有时间一致的尺寸参数 (
,
,
)
- 所有时间一致的颜色参数 (
,
,
)
- 所有时间一致的不透明度参数 (
)
- 所有时间一致的背景颜色参数 (
) 每个高斯总共有
个参数。在我们的实验中,场景由20-30万个高斯表示,其中通常只有30-100万个不属于静态背景。虽然代码具有使用球谐表示视角相关颜色的功能,但出于简化,我们在实验中不使用。
每个高斯根据其不透明度加权的标准(未归一化)高斯方程影响物理3D空间中的一个点(
):
其中
是高斯
在时间步
的中心,
是高斯
在时间步
的协方差矩阵,由缩放组件
和旋转组件
组合而成,其中
是从四元数构造旋转矩阵的公式。
是标准的sigmoid函数。
每个高斯的影响 (
) 既是局部的(能够表示一个小的空间区域),同时在理论上具有无限的范围,使得梯度可以从很远的地方流向它们,这对于基于梯度的可微分渲染的跟踪至关重要,因为目前可能位于错误的3D位置的高斯需要通过可微分渲染器得到梯度,将它们推向正确的3D位置。除了物理密度外,每个高斯还向它影响的每个3D点贡献其自己的颜色(
,
,
)。
通过在时间上固定高斯的大小/不透明度/颜色,每个高斯应该表示空间的相同物理方面,即使这个空间通过时间动态移动。为了表示这种运动,每个高斯都有一个可以随时间移动的中心位置和旋转,从而实现整个场景的密集非刚性6自由度跟踪。
通过高斯三维溅射的可微渲染
为了优化我们的高斯参数以表示场景,我们需要以可微的方式将高斯渲染到图像中。在这项工作中,我们使用可微三维高斯渲染器,并将其扩展到动态场景。这通过将3D高斯点喷到图像平面,通过近似沿着3D高斯深度维度的影响函数
积分的投影,变为在像素坐标中的2D高斯影响函数实现。高斯的中心使用标准的点渲染公式得到:
其中,通过与世界到相机外参矩阵
相乘,z标准化,并乘以内在投影矩阵
,3D高斯中心
投影为2D图像。3D协方差矩阵喷洒到2D:
其中
是上述点投影公式的雅可比矩阵,即
。
现在可以在2D中为每个像素的每个高斯评估影响函数
。通过按深度顺序对高斯进行排序,执行前向体积渲染,可以组合此像素上所有高斯的影响:
其中,每个像素的最终渲染颜色(
)是每个高斯的颜色的加权和.
基于物理的先验
我们发现仅仅固定高斯的颜色、不透明度和大小是不够的,特别是在场景中存在大面积近似均匀颜色的区域,高斯在这些区域自由移动而没有限制。由于我们试图建模物理运动的场景,因此寻找非刚性物理建模的灵感,以便在优化过程中进行物理合理的正则化并得到正确的长期跟踪结果。我们引入了三个正则化损失,短期局部刚性
和局部旋转相似性
损失,以及长期局部等距损失。
其中最重要的是局部刚性损失
,定义为:
这表示对于每个高斯
,附近的高斯
应以跟随
在时间步之间的坐标系的刚体变换方式移动。见图4进行直观解释。
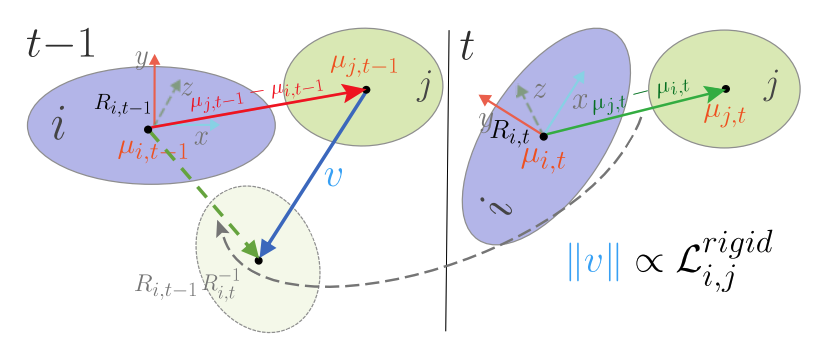
图 4
由于我们执行在线优化,所有的
都是固定的,而我们正在优化
以确保它们与
中的值匹配,直到由 Gaussian
自身坐标系的变化定义的刚体变换。例如,如果
旋转,那么
需要以一种等效于围绕
的中心旋转的方式(在它自己的坐标系中)进行平移。这个损失也适用于相反的方式,迫使旋转匹配平移,从而我们对空间中的每个密集点都获得准确的旋转(6自由度)跟踪,即使我们只优化以匹配渲染图像,这在点表示中是不可能的。
我们将高斯
的集合限制为
的 k-最近邻(k=20),并使用高斯对的加权因子进行加权:
这是一个各向同性高斯加权因子。我们将
设置为 2000,这给出了标准差约为 2.2cm,通过计算第一个时间步中高斯中心之间的距离并在其余时间步上固定它来计算这一点。这导致刚性损失仅在局部强制执行,同时仍允许全局非刚性重建。
刚性损失本身是必要且足够的,以实现良好的结果。由于刚性损失适用于所有点,它在任何对
和
的任何对之间以双向方式应用,因此隐式地强制
和
具有相同的旋转。然而,我们发现如果我们明确地强制邻近的高斯在时间上具有相同的旋转,会有更好的收敛性:
其中
是每个高斯旋转的归一化四元数表示,这使得优化更加平滑。我们使用与之前相同的 k-最近邻和权重函数。
我们仅在当前时间步和直接前一时间步之间应用
和
,因此仅在短时间范围内强制执行这些损失。有时这会导致场景的一些元素分离,因此我们在长期内应用第三个损失,等距损失:
这是
的一个较弱的约束,因为它只强制两个高斯之间的距离相等,而不是强制它们的位置相同。
实验结果
PanopticSports数据集结果
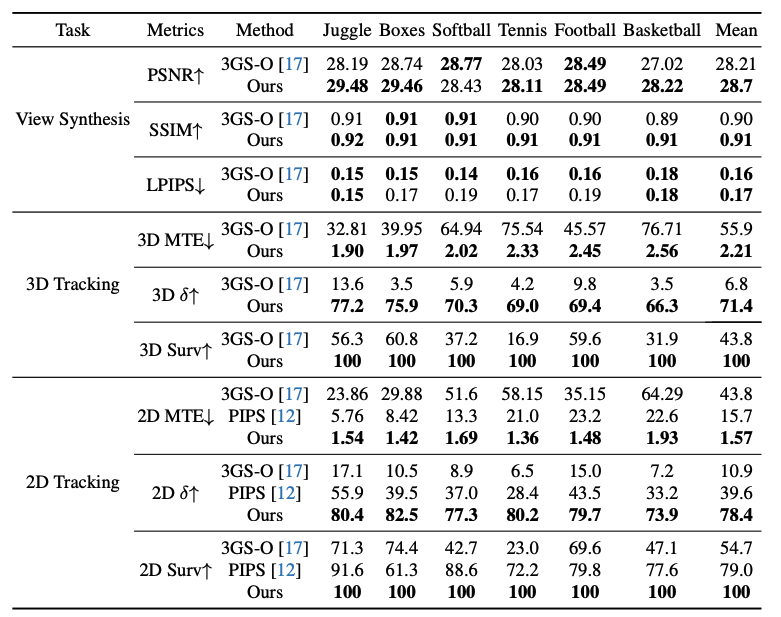
表 1
在我们准备的PanopticSports数据集上,我们在表1中展示了结果。我们的方法在所有三个新视图合成指标上都取得了良好的成绩,最终 PSNR 得分为 28.7。与原始的 3D 高斯飞溅方法相比,我们在所有场景中通过正确建模动态场景的时间一致性,获得了更好的 PSNR 和 SSIM 得分(尽管 LPIPS 稍差)。
在 3D 跟踪方面,我们的方法取得了出色的结果,所有场景中所有轨迹的中位轨迹误差仅为 2.21 厘米。这小于通过极其复杂且快速的运动跟踪 150 个时间步骤中手腕的宽度。我们的方法在所有序列中都具有 100% 的存活率,从不失去需要跟踪的点,并且准确度值为 71.4。原始的高斯飞溅方法完全无法正确跟踪3D中的点,中位轨迹误差更高达 55.9 厘米。我们的方法与真值的视觉比较可在图5中找到。
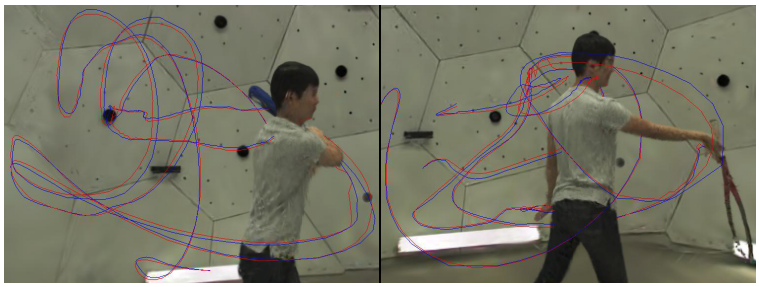
图 5
Particle-NeRF数据集结果
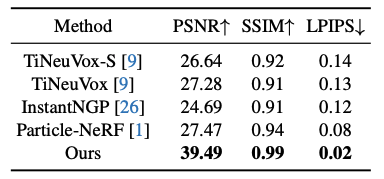
表 2
在 Particle-NeRF 数据集上,我们的方法在 PSNR、SSIM 和 LPIPS 的所有指标上都取得了几乎完美的分数。这是因为该数据集在简单的合成对象和简单的运动方面相对简单。我们的方法的结果与 Particle-NeRF 的结果进行了视觉比较,如图6 所示。
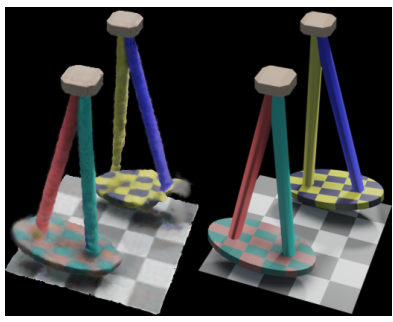
图 6
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2023-12-28,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号