Pandas数据处理——通过value_counts提取某一列出现次数最高的元素

Pandas数据处理——通过value_counts提取某一列出现次数最高的元素
红目香薰
发布于 2023-02-23 14:19:59
发布于 2023-02-23 14:19:59
这个图片的来自于AI生成,我起名叫做【云曦】,根据很多的图片进行学习后生成的
Pandas数据处理——渐进式学习——通过value_counts提取某一列出现次数最高的元素
目录
Pandas数据处理——渐进式学习——通过value_counts提取某一列出现次数最高的元素
前言
这个女娃娃是否有一种初恋的感觉呢,但是她很明显不是一个真正意义存在的图片,我们需要很复杂的推算以及各种炼丹模型生成的AI图片,我自己认为难度系数很高,我仅仅用了64个文字形容词就生成了她,很有初恋的感觉,符合审美观,对于计算机来说她是一组数字,可是这个数字是怎么推断出来的就是很复杂了,我们在模型训练中可以看到基本上到处都存在着Pandas处理,在最基础的OpenCV中也会有很多的Pandas处理,所以我OpenCV写到一般就开始写这个专栏了,因为我发现没有Pandas处理基本上想好好的操作图片数组真的是相当的麻烦,可以在很多AI大佬的文章中发现都有这个Pandas文章,每个人的写法都不同,但是都是适合自己理解的方案,我是用于教学的,故而我相信我的文章更适合新晋的程序员们学习,期望能节约大家的事件从而更好的将精力放到真正去实现某种功能上去。本专栏会更很多,只要我测试出新的用法就会添加,持续更新迭代,可以当做【Pandas字典】来使用,期待您的三连支持与帮助。
环境
系统环境:win11 Python版本:python3.9 编译工具:PyCharm Community Edition 2022.3.1 Numpy版本:1.19.5 Pandas版本:1.4.4
基础函数的使用
Pandas数据处理——渐进式学习、DataFrame(函数检索-请使用Ctrl+F搜索)
value_counts函数
函数语法
value_counts(normalize=False, sort=True, ascending=False, bins=None, dropna=True)参数说明
- normalize : boolean, default False 默认false,如为true,则以百分比的形式显示
- sort : boolean, default True 默认为true,会对结果进行排序
- ascending : boolean, default False 默认降序排序
- bins : integer, 格式(bins=1),意义不是执行计算,而是把它们分成半开放的数据集合,只适用于数字数据
- dropna : 对元素进行计数的开始时默认空值
具体示例
模拟数据
import pandas as pd
import numpy as np

df = pd.DataFrame(
    {'name': ['张丽华', '李诗诗', '王语嫣', '李诗诗', '李诗诗', '李诗诗', '李诗诗', '王语嫣', '王语嫣', '王语嫣'],
     'sex': ['girl', 'woman', np.nan, 'girl', 'woman', 'woman', 'woman', 'girl', 'girl', 'girl'],
     'age': [22, np.nan, 16, np.nan, 27, 27, 27, 16, 16, 16]
     }
)
print(df)
print("----value_counts----")
# value_counts
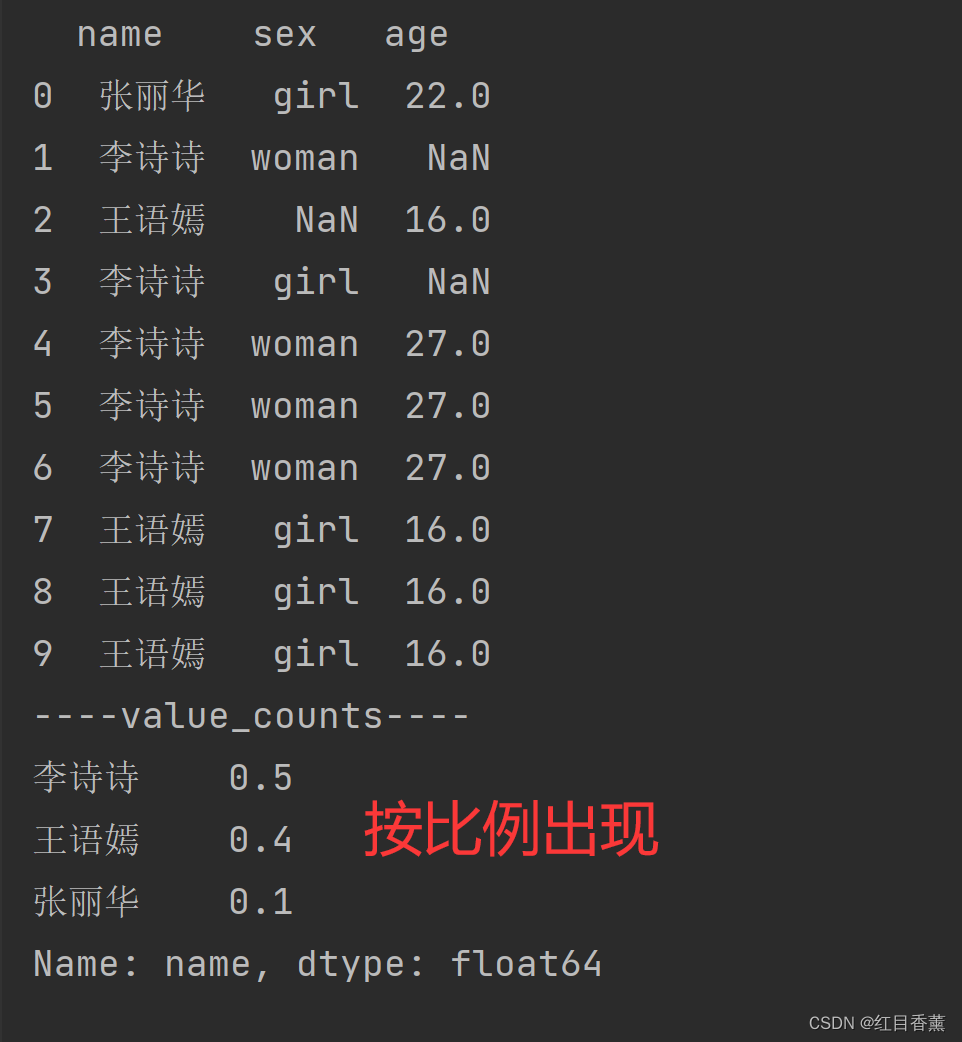
参数normalize=True·百分比显示
import pandas as pd
import numpy as np

df = pd.DataFrame(
    {'name': ['张丽华', '李诗诗', '王语嫣', '李诗诗', '李诗诗', '李诗诗', '李诗诗', '王语嫣', '王语嫣', '王语嫣'],
     'sex': ['girl', 'woman', np.nan, 'girl', 'woman', 'woman', 'woman', 'girl', 'girl', 'girl'],
     'age': [22, np.nan, 16, np.nan, 27, 27, 27, 16, 16, 16]
     }
)
print(df)
print("----value_counts----")
# value_counts
df = df['name'].value_counts(normalize=True)
print(df)
效果
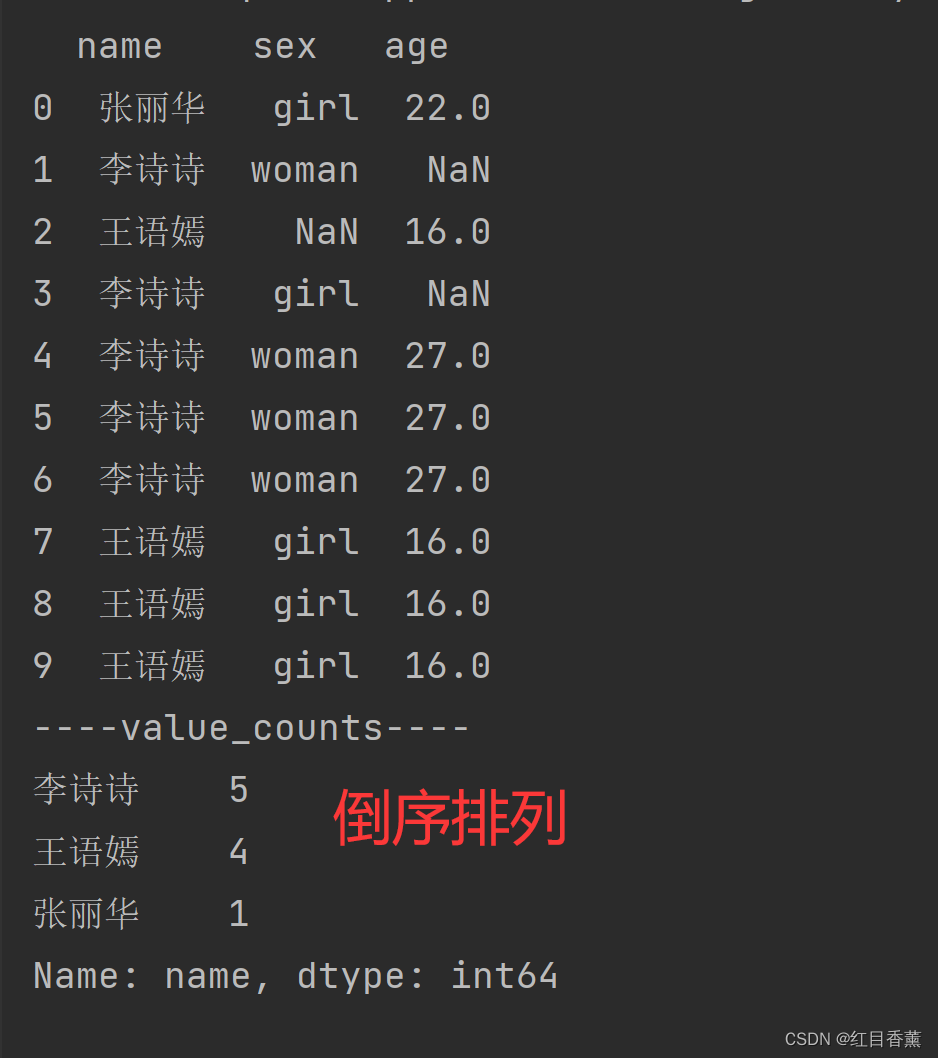
参数sort=True·倒序
import pandas as pd
import numpy as np

df = pd.DataFrame(
    {'name': ['张丽华', '李诗诗', '王语嫣', '李诗诗', '李诗诗', '李诗诗', '李诗诗', '王语嫣', '王语嫣', '王语嫣'],
     'sex': ['girl', 'woman', np.nan, 'girl', 'woman', 'woman', 'woman', 'girl', 'girl', 'girl'],
     'age': [22, np.nan, 16, np.nan, 27, 27, 27, 16, 16, 16]
     }
)
print(df)
print("----value_counts----")
# value_counts
df = df['name'].value_counts(sort=True)
print(df)
效果:
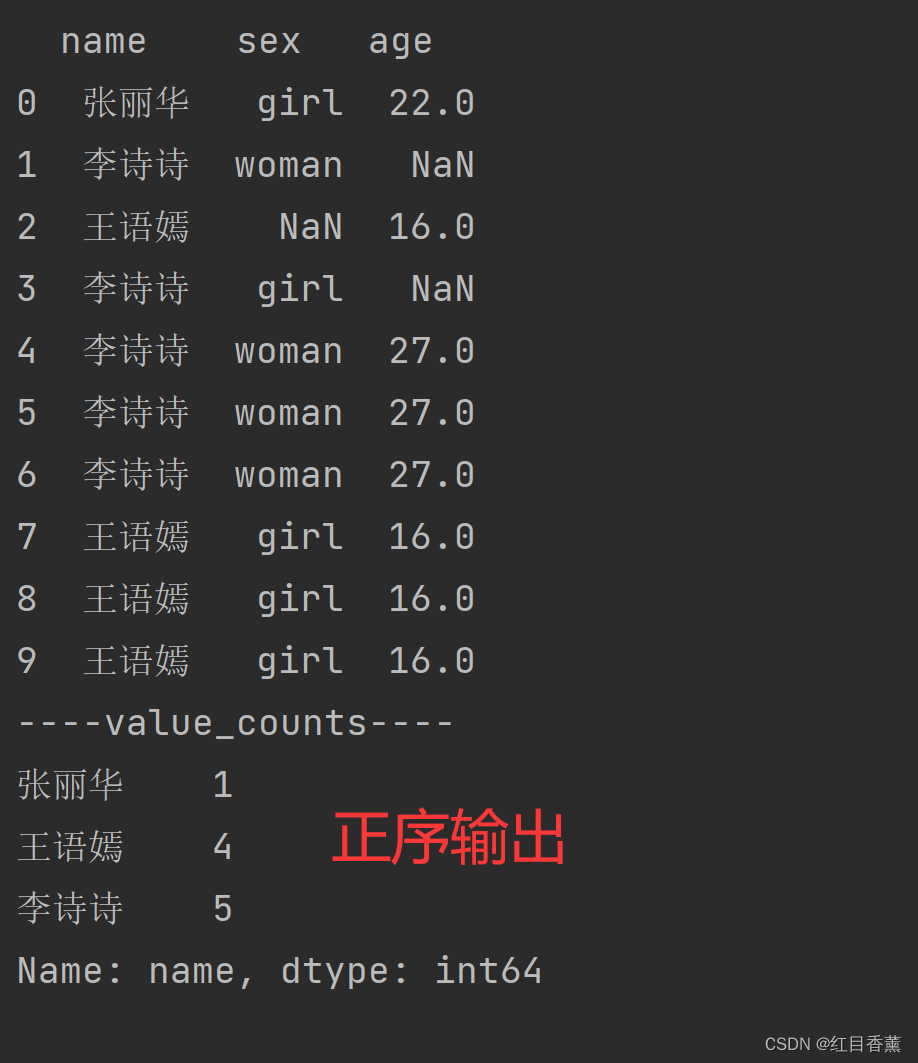
参数ascending=True·正序
import pandas as pd
import numpy as np

df = pd.DataFrame(
    {'name': ['张丽华', '李诗诗', '王语嫣', '李诗诗', '李诗诗', '李诗诗', '李诗诗', '王语嫣', '王语嫣', '王语嫣'],
     'sex': ['girl', 'woman', np.nan, 'girl', 'woman', 'woman', 'woman', 'girl', 'girl', 'girl'],
     'age': [22, np.nan, 16, np.nan, 27, 27, 27, 16, 16, 16]
     }
)
print(df)
print("----value_counts----")
# value_counts
df = df['name'].value_counts(ascending=True)
print(df)
效果:
总结
其实我们测试的过程中就能体会到这个函数的好用之处,直接就能出排序的结果,实在是太方便了,免得我们很多操作了,好东西,谁用谁知道。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2023-02-19,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号